로봇 학습 학회 CoRL 2026 (미국 텍사스주 오스틴, 11월 9–12일)은 메인 프로그램 전체를 네 개의 긴 녹화 영상으로 중계했습니다. 이 페이지는 이를 개별 발표로 나눕니다: 기조연설, 구두 발표, 스포트라이트, 스폰서 발표, 그리고 토론 패널. 각 항목에는 짧은 요약, 핵심 내용, 그리고 해당 발표 구간만 재생하는 플레이어가 있습니다.
요약은 중계 자막과 논문 초록을 바탕으로 작성했습니다. 각 논문은 가능한 경우 arXiv와 프로젝트 페이지, 그리고 OpenReview에 연결됩니다. 제목은 번역하고 영어 원문을 괄호 안에 함께 표기했으며, 이름과 소속은 영어로 유지했습니다.
면책 조항: 이 페이지는 Claude Opus 5.5로 생성되었으며 완전히 검토되지 않아 오류가 있을 수 있습니다. 한국어 번역 역시 AI로 작성되었습니다. 세부 사항은 원본 녹화나 논문에서 확인하세요. 모든 발표, 논문, 슬라이드, 녹화의 권리는 해당 저자와 CoRL 2026에 있습니다.
컨퍼런스 개요
CoRL 2026은 규모가 세 배로 커졌고 핵심 구성 요소(대규모 사전학습 정책, 인간 영상, 월드 모델, 프런티어 모델 플래너)에 대해서는 대체로 수렴했지만, 그 레시피가 누군가 돈을 내고 살 로봇을 만들어 낼지를 두고는 공개적으로 논쟁을 벌였다.
제출 논문
2,094
프로그램 위원장에 따르면 2025년 ~700편에서 증가; 687편 채택
채택률
32.8%
예년과 비슷한 수준; 구두 발표는 채택 논문의 ~3%, 스포트라이트 72편
참석자
~4,800
총괄 위원장에 따르면 2025년의 약 두 배
리뷰어
2,400+
올해 새로 도입된 23명의 시니어 영역 위원장 별도
채택된 late-breaking 결과
89건 중 39건
새로운 에이전틱 로보틱스 및 real-to-sim-to-real 트랙
환각 인용으로 인한 데스크 리젝트
~12
CoRL이 이를 처음으로 검사한 해
열 번째 CoRL에는 2,094편의 논문이 제출되어 2025년의 약 700편보다 약 세 배 늘었고, 오스틴의 세 개 행사장에 약 4,800명이 참석했다. 프로그램 위원장들은 포스터 전용 트랙과 3분 스포트라이트를 추가해 32.8%의 채택률과 단일 트랙을 유지했다. 제출 논문의 상위 키워드는 조작, 모방학습, 인지/제어 표현, RL, 로봇 파운데이션 모델이었으며, 채택 논문도 이 분포를 거의 그대로 따랐다. 에이전틱 로보틱스와 real-to-sim-to-real에 관한 새로운 late-breaking 트랙은 불과 몇 달 전에 공개된 프런티어 모델에 대응한 것이다.
무대 위에서 기술적 그림은 전략적 그림보다 더 정리되어 있었다. Physical Intelligence, NVIDIA, Google DeepMind와 여러 학계 연구실은 같은 스택을 제시했다. BC로 사전학습한 대규모 정책, 규모 확보를 위한 인간 1인칭 시점 데이터, 데이터 생성과 평가를 위한 월드 모델, 그리고 그 위에서 계획을 담당하는 프런티어 모델이다. 의견이 갈린 지점은 이 스택이 신뢰할 수 있고 수익성 있는 배포에 도달하느냐였다. 이 질문을 다룬 폐막 토론 전후의 투표는 반대 쪽으로 기울었고 거의 변하지 않았다. Ken Goldberg (UC Berkeley)는 이 분야가 '수익 위기'에 처해 있다고 표현했는데, 이제 신뢰성, 처리량, 해석 가능성을 내놓아야 한다는 의미다.
전체 개요 읽기전체 개요 접기
주제
위에는 프런티어 모델, 아래에는 빠른 정책
대부분의 시스템은 느린 추론기를 빠른 학습 기반 제어기 위에 얹는다. Hang Zhao (Tsinghua University / Galaxea AI)는 프런티어 모델을 실제 시간 제약 아래에서 단계별 정책으로 사용하면 RoboCasa에서 성공률이 15-20%로 떨어진다고 보고했으며, 대부분의 실패가 계층 사이의 인계 지점에서 발생한다고 주장했다. Boston Dynamics는 파인튜닝 없이 작업 완료 여부를 확인할 만큼 신뢰할 수 있는 기성 VLM은 없었다고 밝혔다. 토론에서 Vincent Vanhoucke (Waymo)는 일부 로보틱스 벤치마크에서 범용 모델이 이 학회의 로봇 모델을 이기고 있다고 말했고, Pulkit Agrawal (MIT / Eka Robotics)은 접촉이 많은 시스템 1 데이터가 아직 그 모델들에 빠져 있다고 반박했다.
DreamZero와 GR00T 2는 영상과 행동을 함께 디노이징한다. DreamZero 저자들은 실패가 주로 영상 생성에서 비롯된다는 것을 발견했으며, 따라서 더 나은 영상 백본이 더 나은 행동으로 이어질 것이라고 본다. SuperMimic은 하나의 학습된 미분 가능 동역학 모델을 통해 약 3 GPU-시간 만에 휴머노이드 트래커를 학습시켜 최우수 논문상을 받았다. Tesla는 월드 모델로 평가만 하는 것이 아니라 그 안에서 학습하면 정책이 모델의 물리적 오류를 악용하게 된다고 경고했다. 또 다른 스포트라이트는 월드 모델이 오염(poisoning)될 수 있음을 보였다.
EgoScale은 인간 데이터의 검증 손실이 실제 로봇 성공률을 따라가는 로그-선형 스케일링 법칙을 따른다는 것을 보였다. 또한 가장 어려운 정교한 작업에는 정렬된 중간 학습 단계(약 4시간의 원격 조작 데이터와 이에 대응하는 50시간의 인간 데이터)가 필요했다. Ego2Robot은 손 자세 정확도가 정밀 작업에서의 성능 향상을 제한한다는 것을 발견했다.
여러 논문이 접촉이 많은 작업에서의 VLA 실패 원인을 힘 신호의 부재, 혹은 접촉 직전의 작은 행동을 과소 가중하는 플로 매칭 노이즈 스케줄에서 찾았다. 해결책은 저렴하다. 범용 로봇 팔을 위한 학습 기반 토크 추정, 이미지 위에 그린 촉각 화살표, 사후학습 후반에 추가하는 힘 전문가(force expert) 등이다. Wolfram Burgard (University of Technology Nuremberg)와 Sharpa는 모두 로봇 파운데이션 모델에 힘과 촉각이 필요하다고 주장했다.
RL은 대부분 범용 모델을 대체하기보다 사전학습된 범용 모델 위에 적용되었다. RL Token은 압축된 VLA 임베딩 위에서 작은 actor-critic을 돌려 작업의 가장 어려운 단계를 몇 시간 안에 개선하며, 이더넷 케이블 삽입 에피소드는 숙련된 원격 조작자보다 빨랐다. 반면 π0.7은 품질 메타데이터를 조건으로 사용해 품질이 섞인 데이터에서 학습할 수 있게 하며, Play2Perfect는 시뮬레이션에서의 RL 놀이(play) 사전학습이 희소 보상 조립 작업을 학습 가능하게 만든다는 것을 보인다.
한 최우수 논문상 최종 후보는 DINO와 MLP를 결합한 정책이 LIBERO에서 보고된 최고 점수에 거의 근접하며, 보고된 성능 향상 중 통계적으로 유의한 것은 거의 없다는 것을 보였다. RoboColosseum은 유의한 결론 하나를 얻는 데 400-500회의 비교가 필요하다고 추정했다. LIBERO-CF는 VLA가 학습 작업에 나온 물체를 보면 언어 지시를 종종 무시한다는 것을 발견했다.
산업계 발표는 운영 지표를 보고했다. Hyundai에서 부품 시퀀싱을 하는 Atlas는 완료율 98.6%, 개입률 9.5%를 기록했지만, 사이클 타임이 수익을 내기에는 약 50% 느리다. Walden의 Toyota 캠샤프트 셀은 한 번도 라인을 멈춘 적이 없다. Gemini Robotics 2.5는 96%의 자율 키팅을 보고했다. 토론에서는 사람에게 돈을 주고 도메인 내 데이터를 수집하게 하는 방식이 세탁 같은 작업 외에서도 경제성을 가질 수 있는지를 두고 의견이 갈렸다.
2026년 위원장들에 따르면 서울 대회는 약 700편의 제출 논문 중 263편을 채택했으며, 비공식 집계로는 현장 참석자가 2,441명이었다. 오스틴 대회는 2,094편을 접수하고 약 4,800명이 참석했으며, 이를 감당하기 위해 포스터 전용 트랙, 시니어 영역 위원장, 반박(rebuttal) 이전의 1차 리젝트, 인용 검사를 도입했다.
수상작의 초점이 작업 성과에서 학습 기법으로 이동했다
2025년 최우수 논문상은 다리형 로봇의 이동-조작을 위한 위치/힘 통합 제어와 Fabrica의 양팔 조립에 돌아갔고, π0.5와 DexUMI가 최종 후보였다. 2026년 수상작은 휴머노이드 제어 학습에 사용된 학습 기반 월드 모델(SuperMimic)과 컨텍스트 스케일링(RoboTTT)이었다.
모델 공개의 성과가 이제 공장에서 측정된다
Google DeepMind는 CoRL 2025 즈음에 Gemini Robotics 1.5를 발표했다. 오스틴에서 Gemini Robotics 2.5는 생산 라인 키팅 파일럿과 함께 등장했다. Physical Intelligence는 π0.5에서 π0.7로 나아갔다. 2025년 특별 패널은 휴머노이드 학습을 논의했고, 2026년 패널은 상업적 실현 가능성을 놓고 토론했다.
VLA와 real2sim에서 에이전트와 월드 모델로
2025년의 한 조사는 VLA, Real2Sim2Real, 촉각 센싱을 CoRL의 주요 주제로 꼽았다. 세 주제 모두 2026년에도 이어졌고, Real2Sim2Real은 별도의 late-breaking 트랙을 갖게 되었다. 새로운 것은 에이전틱 로보틱스 트랙과, 영상과 행동을 함께 학습하는 월드 액션 모델로, 둘 다 2025년에는 주제가 아니었다.
2027년 전망
파리에서는 평가 규범이 더 엄격해질 것이다
예측: 신뢰 구간을 보고하고 보류(held-out) 또는 공개 이후 테스트 세트를 사용하는 논문이 늘어나고, 리뷰어들은 LIBERO와 SimplerEnv에서의 성능 향상에 의문을 제기할 것이다. 근거: 바로 이 주제를 다룬 최우수 논문상 최종 후보, RoboColosseum의 무료 평가 제안, 그리고 마감 시간 내 성공률과 시간당 개입 횟수 지표를 요구한 기조연설들.
계층 간 인터페이스가 연구 대상이 된다
예측: 연구의 초점이 시스템 1과 시스템 2 사이에서 오가는 것으로 옮겨갈 것이다. 위로는 실패 신호, 아래로는 힘 또는 접촉 의도가 전달된다. 근거: Zhao의 인계 실패 분석, 시스템 1이 병목이라는 Agrawal의 주장, 그리고 NVIDIA와 Boston Dynamics의 에이전틱 하네스.
월드 모델은 그 안에서 학습할 수 있는지로 평가받을 것이다
예측: 월드 모델 논문은 영상이 그럴듯해 보인다는 것만이 아니라, 그 안에서 학습한 정책이 오류를 악용하지 않으며 모델 내에서 예측한 성공률이 실제 성공률과 일치한다는 것을 보여야 할 것이다. 근거: Tesla의 경고, 여전히 성공률을 과소추정하는 MemWorld, 그리고 오염 공격.
배포 주장에서 처리량이 성공률을 대체한다
예측: 2027년 산업계 발표는 사이클 타임, 평균 개입 간격, 원격 운영자 1인당 로봇 수를 앞세울 것이다. Boston Dynamics는 2027년에 Atlas의 첫 8시간 교대 근무를 예상했고, Goldberg는 올해의 과제를 수익으로 규정했다. BC 사전학습과 도메인 내 데이터의 조합이 그 기준을 넘을 수 있을지는 계속 논쟁거리로 남을 것이다.
핵심 내용
이 분야는 하나의 스택으로 대체로 수렴했다. 남은 질문은 아키텍처가 아니라 경제성이다.
프런티어 모델은 플래너로서는 도움이 되지만, 실제 시간 제약 아래 단계별 직접 제어기로서는 실패했다.
인간 1인칭 시점 데이터는 규모를 키울 수 있지만, 정밀한 조작에는 여전히 로봇과 인간 데이터를 정렬한 중간 학습이 필요했다.
기존 VLA에 힘과 촉각을 저렴하게 추가할 수 있으며, 그렇게 하면 특정 접촉 실패가 해결된다.
이제 대부분의 RL은 처음부터 학습하는 대신 사전학습된 범용 모델의 병목 단계를 겨냥한다.
널리 쓰이는 시뮬레이션 벤치마크는 대부분 암기로 풀 수 있으며, 보고된 성능 향상의 대부분은 노이즈 범위 안에 있다.
최우수 논문상은 학습된 미분 가능 월드 모델 안에서 휴머노이드 제어를 학습시킨 연구에 돌아갔다.
배포 사례는 개입을 포함해 약 99%의 완료율에 도달하지만, 수익을 내기에는 여전히 너무 느리다.
Yuke Zhu (UT Austin / NVIDIA), Peter Stone (UT Austin / Sony AI), Georgia Chalvatzaki (TU Darmstadt), Ani Majumdar (Princeton University), Roberto Martin-Martin (UT Austin)
총괄 위원장 Yuke Zhu가 열 번째 CoRL의 문을 열며, 참석자가 두 배로 늘고 제출 논문이 약 세 배 증가해 2,100편 가까이에 이르렀다고 밝히고, Hilton, JW Marriott, UT의 Bass Concert Hall에 걸쳐 진행되는 South by Southwest 방식의 구성을 설명한다. 프로그램 위원장들은 새로운 3단계 프로그램(구두 발표, 3분 스포트라이트, 포스터 전용), 32.8%의 채택률, 에이전틱 로보틱스와 real-to-sim-to-real에 관한 새로운 late-breaking 결과 트랙, 시니어 영역 위원장, 그리고 환각 인용 문제로 약 12편의 논문을 데스크 리젝트한 정책을 소개한다. 이어 워크숍, 데모, 현지, 포용성 담당 위원장들이 반일 워크숍, 17개의 데모, 행사장, 점심, Wi-Fi, 여행 지원금, 육아 지원을 안내하고, 마지막으로 Peter Stone이 Texas Robotics와 새로 설립된 UT School of Computing을 소개한 뒤 스폰서들에게 감사를 전한다.
핵심 내용
제출 논문이 약 700편에서 2,100편 가까이로 늘어나, 단일 트랙을 유지하기 위해 3단계 발표 형식을 도입할 수밖에 없었다.
채택률은 32.8%로 예년과 비슷하게 유지되었고, 채택 논문의 키워드 분포는 전체 제출 논문의 분포와 거의 일치했다.
처음으로 여러 개의 환각 인용이나 잘못된 인용이 있는 논문이 표시되었고 약 12편이 데스크 리젝트되었으며, 그 밖의 AI 보조 글쓰기는 저자의 판단에 맡겨졌다.
1차 리젝트로 반박(rebuttal) 이전에 제출 논문의 3분의 1 남짓이 걸러져, 리뷰 노력이 적어도 한 명의 지지자가 있는 논문에 집중되었다.
학생 등록비는 원가보다 낮은 $200로 인하되었고, 학생들의 진입 장벽을 낮추기 위해 스폰서가 그 차액을 지원했다.
워크숍은 미니 학회식 발표 나열보다 상호적인 토론을 장려하기 위해 반일로 운영되었으며, 유효한 제안 78건 중 32건이 채택되었다.
MolmoAct2: 실제 환경 배포를 위한 행동 추론 모델 (MolmoAct2: Action Reasoning Models for Real-World Deployment)
Jiafei Duan · Allen Institute for AI / University of Washington / National University of Singapore
전체 저자
Haoquan Fang1,2, Jiafei Duan1,2,3, Donovan Clay1,2, Sam Wang1,4, Shuo Liu2, Weikai Huang1,2, Xiang Fan1,2, Wei-Chuan Tsai2, Shirui Chen1,2, Yi Ru Wang1,2, Shanli Xing2, Jaemin Cho1,2,5, Jae Sung Park1, Ainaz Eftekhar1,2, Peter Sushko1, Karen Farley1, Angad Wadhwa2, Cole Harrison6, Winson Han1, Ying-Chun Lee2, Eli VanderBilt1, Rose Hendrix1, Suveen Ellawela7, Lucas Ngoo7, Joyce Chai8, Jason Ren1,2,9, Ali Farhadi1,2, Dieter Fox1,2, Ranjay Krishna1,2
1Allen Institute for AI2University of Washington3National University of Singapore4University of Pennsylvania5Johns Hopkins University6Amazon7Cortex AI8University of Michigan9University of North Carolina at Chapel Hill
저자들은 사전학습, 중간 학습, 적응까지 아우르는 공개 레시피를 갖춘 완전 공개 로보틱스 파운데이션 모델 MolmoAct2를 소개한다. 이 모델은 공간 이해에 특화된 VLM을 행동 전문가(action expert)에 연결하고, 매 단계 깊이를 다시 생성하는 대신 적응적으로 깊이를 추론한다. 별도 조정 없이도 공개 임바디드 추론 벤치마크에서 강력한 베이스라인을 능가하며, 파인튜닝 후에는 제3자 기업의 블라인드 평가도 받았다.
핵심 내용
깊이 추론은 매 시간 단계마다 모든 토큰을 다시 생성하는 대신 적응적으로 갱신되어, 추론이 강화된 제어를 효율적으로 유지한다.
파인튜닝된 모델을 평가하는 데 처음으로 제3자 블라인드 평가가 사용되었다.
저자들은 공개가 결실을 맺는다고 주장한다. MolmoAct 모델과 데이터는 Hugging Face에서 150만 회 이상 다운로드되었으며, 이는 무엇이 전이되는지 파악하는 데 도움이 된다.
1Peking University2Eastern Institute of Technology, Ningbo3Shanghai Jiao Tong University
거울 뉴런에서 영감을 받은 저자들은 VLA의 행동 표현이 파인튜닝 과정에서 사전학습된 비전-언어 의미와의 정렬을 잃으며, 이 정렬이 작업 성공과 상관관계가 있음을 보인다. 이들은 특징을 고정된 VLM과 정렬되는 공유 의미 경로와 실행 세부 사항을 유지하는 개별 경로로 나누어, 시뮬레이션과 실제 로봇에서 여러 VLA(pi0 포함)의 성능을 향상시킨다.
핵심 내용
행동 표현의 의미적 정렬은 파인튜닝 중 측정 가능할 정도로 약화되며, 롤아웃 성공률 및 분포 밖 일반화와 함께 움직인다.
모든 특징을 의미에 정렬하면 실행 성능이 떨어지므로, 물리적 세부 사항을 보존하려면 공유/개별 특징 분리가 필요하다.
MEM: Vision Language Action 모델을 위한 다중 스케일 임바디드 메모리 (MEM: Multi-Scale Embodied Memory for Vision Language Action Models)
Marcel Torne · Physical Intelligence / Stanford University
전체 저자
Marcel Torne1,2, Karl Pertsch1, Homer Walke3, Kyle Vedder1, Suraj Nair1, brian ichter1, Allen Z. Ren1, Haohuan Wang1, Jiaming Tang1,4, Kyle Stachowicz1,3, Karan Dhabalia1, Michael Robert Equi1, Quan Vuong1, Jost Tobias Springenberg1, Sergey Levine1, Chelsea Finn1, Danny Driess1
저자들은 VLA에 다중 스케일 메모리를 추가한다. 하나는 최근 몇 초간의 시각 정보를 비디오 인코더로 압축해 저수준 정책에 입력하는 단기 시각 메모리이고, 다른 하나는 VLM이 과거 사건의 요약을 순환적으로 예측하는 장기 텍스트 메모리다. 이를 통해 정책은 레시피대로 요리하고 주방을 청소하는 것처럼 최대 15분이 걸리는 작업을 처리할 수 있다.
핵심 내용
원시 영상 이력을 그대로 입력하는 것은 불가능하다. 50 Hz에서 이미지당 256개 토큰으로 1시간이면 약 5천만 개의 토큰이 된다.
어블레이션 결과, 장기 과제를 해결하려면 장기 텍스트 메모리와 단기 영상 메모리가 모두 필요하다.
메모리는 인컨텍스트 적응을 가능하게 하여, 정책이 시도의 실패를 알아차리고 같은 실수를 반복하는 대신 다른 전략을 시도하게 한다.
PRTS: 대조 표현 기반의 기초 동작 추론 및 작업 수행 시스템 (PRTS: A Primitive Reasoning and Tasking System via Contrastive Representations)
Yang Zhang · TeleAI, China Telecom / Tsinghua University (녹화에서 발표자가 언급되지 않아 제1저자를 표시)
전체 저자
Yang Zhang1,2, Jiangyuan Zhao1,3, Chenyou Fan1,4, Fangzheng YAN1, Tian Li1, Haitong Tang1, Sen Fu1, Xuaner Wu1, Qizhen Weng1, Weinan Zhang3, Xiu Li2, Chi Zhang1, Chenjia Bai1, Xuelong Li1
1TeleAI, China Telecom2Tsinghua University3Shanghai Jiao Tong University4Fudan University
PRTS는 VLA 사전학습을 목표 조건부 대조 RL로 재정식화한다. 언어 지시를 목표로 취급함으로써 상태-행동 임베딩이 보상 주석 없이 목표를 향한 진행 정도를 포착하게 하고, 이를 행동 토큰 예측과 결합해 4억 개 샘플 규모로 확장한다. 그 결과 얻은 정책은 사람의 강한 방해에서도 회복하고, 새로운 지시를 제로샷으로 따르며, 장기 쟁반 정리 작업에서 처음 보는 상황에도 대응한다.
핵심 내용
같은 지시에 속한 단계를 양성 쌍으로 취급하고 뒤쪽 단계에 더 큰 가중치를 주어, 임베딩이 목표를 향한 시간적 진행을 인코딩하게 한다.
대조 사전학습에는 별도의 보상 레이블이 필요 없으며, 다운스트림 사후학습은 새로 초기화한 플로 매칭 행동 전문가와 함께 표준 행동 복제를 사용한다.
정책은 어떤 시연에도 없던 빈 그릇 상황을 처리해 냈으며, 이는 진행 정도를 인식하는 표현이 회복에 도움이 됨을 시사한다.
VLA에게 무엇을 말할지 학습하기: 대체로 무해한 Vision Language Action 모델 조향 (Learning What to Say to Your VLA: Mostly Harmless Vision Language Action Model Steering)
Hyun Joe Jeong · Carnegie Mellon University
전체 저자
Hyun Joe Jeong1, Gokul Swamy1, Andrea Bajcsy1
1Carnegie Mellon University
저자들은 국소적으로 변형한 언어 시퀀스를 탐색하고 이를 폐루프로 실행한 뒤, 가장 좋은 것을 거절 파인튜닝(rejection fine-tuning)으로 VLM에 증류하는 방식으로, 고정된 VLA를 조향하는 언어 피드백 정책을 학습한다. 컨포멀 예측을 적용한 개선 헤드가 언제 개입할지 결정하여 '해를 끼치지 않는다'는 보장을 제공하며, 시뮬레이션과 실제 하드웨어에서 pi0.5와 MolmoAct2의 성공률이 상승한다.
핵심 내용
VLA의 언어-행동 매핑은 취약해서, 지시를 바꿔 말하는 것만으로도 행동이 예측 불가능하게 달라질 수 있다.
개선 헤드에 컨포멀 예측을 적용하면 조향이 도움이 되지 않을 가능성이 높을 때 시스템이 원래 지시로 되돌아갈 수 있다.
저자들은 50개 이상의 반사실적 작업으로 구성된 벤치마크 LIBERO-CF를 소개하며, VLA가 시각적 지름길 때문에 언어를 무시하고 잘 학습된 학습 작업을 반복하는 경우가 많다는 것을 보여 준다. 이들은 언어 조건부 행동 예측과 무조건부 행동 예측의 차이를 증폭하는 이중 분기 추론 기법인 Counterfactual Action Guidance를 제안하여, 시뮬레이션과 실제 로봇의 pi0.5에서 언어 그라운딩을 개선한다.
핵심 내용
LIBERO에서 VLA는 시각 입력만으로도 높은 성공률에 도달해, 시각 단서에 크게 의존하고 있음을 드러낸다.
반사실적 실패는 학습 작업에 등장한 물체의 존재로 촉발되며, 이를 제거하면 정책이 지시를 따르는 데 도움이 된다.
EmbodiSteer: 제로샷 크로스 임바디먼트 배포를 위한 관절 공간 가이던스 기반의 임바디먼트 비의존 시각운동 정책 조향 (EmbodiSteer: Steering Embodiment-Agnostic Visuomotor Policies with Joint-Space Guidance for Zero-Shot Cross-Embodiment Deployment)
EmbodiSteer는 핸드헬드 그리퍼 데이터로 학습한 데카르트 공간 시각운동 정책을 고정한 채, 순기구학과 자코비안을 통해 디퓨전 샘플링을 대상 로봇의 관절 공간으로 옮긴다. 각 디노이징 단계에서 최적화 기반 가이던스가 충돌 회피 여유와 엔드 이펙터 동작 변화 사이의 균형을 맞추어, 시뮬레이션 로봇 9대와 실제 로봇 2대에서 몸체를 인식하는 제로샷 배포를 가능하게 한다.
핵심 내용
관절 공간에서 디노이징해도 작업 성능은 거의 그대로 유지되면서 전신 인식이 더해진다.
단순한 그래디언트 기반 충돌 가이던스는 그리퍼를 작업에서 벗어나게 하므로, 제약 조건과 엔드 이펙터 동작 사이의 균형이 필요하다.
실제 작업에서 로봇별 학습 없이 성공률이 거의 두 배가 되었고 충돌은 97%에서 7%로 줄었다.
저자들은 순차적 작업에서의 조합적 일반화 격차를 주변 지시 분포 이동, 지시 조합 이동, 컨텍스트-행동 이동으로 분해하고, 이를 이용해 로봇이 실제로 어떤 지시 조합을 보아야 하는지 묻는다. 실험 결과, 희소하더라도 잘 선택된 커버리지면 충분하며, 희소 커버리지에서의 실패는 기술의 부재가 아니라 지시 조향에서 비롯된다는 것을 보인다.
핵심 내용
모든 조합을 다 커버할 필요는 없다. 신중하게 고른 4분의 1의 데이터로 전체 학습과 같은 성능을 낼 수 있다.
작업당 시연 하나만 추가해도 희소 커버리지 실패의 상당수가 해결되며, 이는 지시 조향이 병목임을 가리킨다.
지시들이 서로 의존할 때는 의존 쌍에 대한 관계적 커버리지가 필요하며, 오라클 고수준 지시자를 사용하는 모듈형 정책은 실패한다.
여러 시간 척도에 걸친 Physical AI의 구성 (Organizing Physical AI Across Timescales)
Hang Zhao · Tsinghua University (IIIS) / Galaxea AI
Chen Feng의 소개로 등단한 Hang Zhao는 로봇 지능을 기능이 아니라 시간 척도에 따라 나누어야 한다고 주장한다. 몇 초 단위로 추론하는 S2, 수십 Hz로 동작하는 S1 정책, 수백 Hz로 동작하는 S0 제어다. 실제 시간 제약을 둔 RoboCasa 연구에서 프런티어 모델을 직접 정책이나 에이전틱 단계별 정책으로 사용하면 성공률이 15-20%로 급락했지만, 느린 모델과 빠른 학습 기술을 짝지은 오케스트레이션 설계는 성능을 유지했다. 그는 양산 차량에 적용된 DriveVLM의 이중 시스템과 로봇 파쿠르에서 얻은 교훈을 바탕으로, S1을 빠르게 유지하는 세 가지 방법을 제시한다. 학습 시에는 영상으로 학습하되 테스트 시에는 영상 생성을 건너뛰는 FastWAM(G0-7), G0.5에서 추론 시 chain-of-thought를 끄는 것, 그리고 스트리밍 행동 토크나이저 ActionCodec 2다. 마지막으로 그는 계층 간 인터페이스에 위로는 더 풍부한 피드백이, 아래로는 힘이나 접촉 의도가 전달되어야 한다고 주장하며, 벤치마크가 추론 시간과 함께 마감 시간 내 성공률을 보고할 것을 요청한다.
핵심 내용
느린 프런티어 모델도 빠른 하위 계층과 결합하면 문제가 없지만, 실제 시간 제약 아래 단계별 직접 정책으로 쓰면 대부분의 작업에서 실패한다.
계층 경계는 요구되는 반응 시간이 바뀌는 곳에 그어야 한다. 작업과 장면은 초 단위, 손-물체 동작은 수십 Hz, 접촉과 힘은 수백 Hz다.
추론 시 chain-of-thought를 건너뛰어도 약 90%의 작업에서는 차이가 없었고 속도는 두 배가 되었으며, 주로 길고 여러 단계로 이루어진 작업에서만 도움이 되었다.
테스트 시 미래 영상 생성을 건너뛰자 월드 액션 모델의 속도가 네 배 이상 빨라졌으며, 16B 규모의 G0-7은 RTX 5090에서 행동당 60 ms로 동작한다.
대부분의 실패는 계층 간 인계 지점에서 발생하는데, 하위 계층이 실패를 위로 보고할 수 없고 동작만 담은 명령에는 힘 정보가 빠져 있기 때문이다.
Zhao는 S2는 클라우드에, S1은 여러 로봇이 공유하는 엣지 서버에, S0는 로봇 자체에 두어야 한다고 제안한다.
π0.7: 창발적 능력을 갖춘 조향 가능한 범용 로봇 파운데이션 모델 (π0.7: a Steerable Generalist Robotic Foundation Model with Emergent Capabilities)
Ashwin Balakrishna, Lucy Xiaoyang Shi · Physical Intelligence
전체 저자
Bo Ai1, Ali Amin1, Raichelle Aniceto1, Ashwin Balakrishna1, Greg Balke1, Kevin Black1, George Elledge Bokinsky1, Shihao Cao1, Thomas Charbonnier1, Vedant Choudhary1, Foster Collins1, Ken Conley1, Grace B Connors1, James Darpinian1, Karan Dhabalia1, Maitrayee Dhaka1, Jared Di Carlo1, Danny Driess1, Michael Robert Equi1, Adnan Esmail1, Yunhao Fang1, Chelsea Finn1, Catherine Glossop1, Thomas Godden1, Ivan Goryachev1, Lachy Groom1, Haroun Habeeb1, Hunter Hancock1, Karol Hausman1, Gashon Hussein1, Victor Hwang1, brian ichter1, Connor Jacobsen1, Szymon Jakubczak1, Rowan Jen1, Tim Jones1, Gregg Kammerer1, Benjamin Katz1, Liyiming Ke1, Mairbek Khadikov1, Chandra Kuchi1, Marinda Lamb1, Devin LeBlanc1, Sergey Levine1, Xinyu Li1, Adrian Li-Bell1, Vladislav Lialin1, Zhonglin Liang1, Wallace Lim1, Yao Lu1, Enyu Luo1, Vishnu Mano1, Nandan Marwaha1, Aikys Mongush1, Liam Murphy1, Suraj Nair1, Karl Pertsch1, Allen Z. Ren1, Gavin Schelske1, Charvi Sharma1, Baifeng Shi1, Lucy Xiaoyang Shi1, Laura Smith1, Jost Tobias Springenberg1, Kyle Stachowicz1, Will Stoeckle1, Jiaming Tang1, James Tanner1, Shalom Tekeste1, Marcel Torne1, Kyle Vedder1, Quan Vuong1, Anna Walling1, Haohuan Wang1, Jason Wang1, XuDong Wang1, Christopher Whalen1, Sam Whitmore1, Blake Williams1, Charles Xu1, Sukwon Yoo1, Lili Yu1, Wuming Zhang1, Zhuoyang Zhang1, Ury Zhilinsky1
1Physical Intelligence
Physical Intelligence는 하위 목표 이미지, 상세한 하위 작업 지시, 그리고 작업이 어떻게 수행되었는지(예: 품질, 실수, 속도)를 기술하는 메타데이터 등 풍부한 멀티모달 프롬프트로 학습한 범용 로봇 파운데이션 모델 π0.7을 소개한다. 별도 조정 없이도 단일 모델이 빨래 개기, 에스프레소 만들기, 상자 접기에서 작업별 RL 사후학습을 거친 π*0.6과 같거나 때로는 더 나은 성능을 보이며, 이전 PI 릴리스의 작업도 파인튜닝 없이 수행한다. 메타데이터 덕분에 모델은 품질이 섞인 원격 조작 데이터와 평가 데이터로부터 학습할 수 있으며, 저자들은 UR5 빨래 데이터가 전혀 없는데도 UR5 양팔 장비에서 셔츠를 개는 것 같은 창발적 조합 일반화를 강조한다. 질의응답에서 저자들은 품질 레이블이 주로 사후 인간 주석에서 나오며, 속도가 품질과 잘 상관되는 신호 중 하나라고 설명한다.
핵심 내용
메타데이터 프롬프트가 없으면 품질이 점점 낮은 빨래 데이터를 추가할수록 성능이 떨어졌지만, 메타데이터가 있으면 데이터가 늘어날수록 성능이 계속 향상되었다.
품질 메타데이터를 조건으로 주면 모델이 좋은 행동과 나쁜 행동을 구분할 수 있어, LLM에게 전문가처럼 행동하라고 지시하듯 테스트 시 고품질 행동을 그냥 요청할 수 있다.
π0.7은 데이터 수집에 사용된 경량 팔과 임바디먼트 차이가 큰데도 빨래 개기를 UR5 양팔 산업용 로봇에 전이했다.
데이터 품질을 판단하는 것은 여전히 열려 있는 반복적인 문제이며, PI는 실제 성능과 상관되는 것을 기준으로 다듬은 사후 주석에 의존한다.
저자들은 인간 손 상호작용 데이터를 로봇 임바디먼트 전반의 보편적 기준점으로 사용하는 VLA인 Being-H0.5를 소개하며, 약 30개 임바디먼트에서 나온 로봇 데이터의 부족과 불균형 문제를 다룬다. 학습 코퍼스는 1인칭 시점 인간 영상에서 재구성한 손 동작, 약 14,000시간의 로봇 데이터, 약 5,000시간의 비전-언어 데이터로 구성되며, 동작 생성, 기술(description), 이어 생성 작업과 함께 공유 슬롯 기반 행동 공간에서 학습된다. 로봇별 특화에는 mixture-of-flow 행동 전문가, 관측 분포 이동을 위한 매니폴드 보존 게이팅 메커니즘, 그리고 RTC를 로봇별 지연으로 확장한 범용 비동기 청킹이 사용된다. 다섯 개 임바디먼트에 걸친 단일 범용 체크포인트가 로봇별 전문 모델에 근접한 성능을 유지하며 일반화에서는 더 낫다.
핵심 내용
인간 중심 사전학습은 범용 모델과 전문 모델 사이의 격차를 좁혔으며, 처음부터 학습할 때는 이 격차가 크게 벌어졌다.
Unitree G1에서만 수집한 작업이 사전학습을 거친 모델에서는 다른 로봇으로 0이 아닌 성공률로 전이되었지만, 처음부터 학습한 모델은 완전히 실패했다.
인간의 손을 공유 행동 슬롯 공간의 또 하나의 임바디먼트로 취급하면, 같은 손실 함수로 인간의 손목 동작이 로봇 엔드 이펙터 슬롯을 지도할 수 있다.
손 동작 레이블은 대부분 휴리스틱 품질 지표로 필터링한 재구성 파이프라인에서 나오며, 손 레이블이 있는 오픈소스 데이터셋으로 보충된다.
RoboTTT: 로봇 정책을 위한 컨텍스트 스케일링 (RoboTTT: Context Scaling for Robot Policies)
Yunfan Jiang · NVIDIA / Stanford University
전체 저자
Yunfan Jiang1,2, Yevgen Chebotar1, Ruijie Zheng1, Fengyuan Hu1, Yunhao Ge1, Jimmy Wu1, Tianyuan Dai1,3, Scott Reed1, Li Fei-Fei2, Yuke Zhu1,3, Linxi Fan1
1NVIDIA2Stanford University3The University of Texas at Austin
RoboTTT는 GR00T N1.7의 DiT 행동 블록에서 나오는 시간 단계별 출력 사이에 빠른 가중치(fast weights)가 학습과 추론 모두에서 경사 하강법으로 갱신되는 테스트 시간 학습(TTT) 레이어를 삽입하여, 로봇 정책의 시각운동 컨텍스트를 8,000 시간 단계까지 확장한다. 학습에는 시퀀스 행동 강제(sequence action forcing, 액션 청크마다 독립적인 노이즈 수준)와 컨텍스트를 모방 목표와 분리하는 손실 마스크를 사용하여, 인간 영상으로부터의 인컨텍스트 모방과 모델이 스스로의 실패를 교정하도록 학습하는 DAgger 증류를 가능하게 한다. 장기 조립 작업에서 일정한 추론 지연 시간으로 평균 79%의 작업 완료율을 달성했으며, 기어봇 조립의 10단계를 모두 완수한 유일한 방법이다. 이 모델은 장기 인간 영상(EgoScale)으로 중간 학습도 거쳤다.
핵심 내용
폐루프 성능은 컨텍스트 길이에 따라 꾸준히 상승해 8K 컨텍스트에서 1K보다 63% 높았으며, 대안인 gated DeltaNet은 확장되지 않았다.
빠른 가중치는 고정 크기의 순환 상태로 작동하여, 컨텍스트 길이와 무관하게 메모리와 지연 시간을 일정하게 유지한다.
액션 청크마다 노이즈 수준을 독립적으로 샘플링하면 시간적으로 상관된 로봇 궤적에서 시퀀스 학습이 안정된다.
World Action Model은 제로샷 정책이다 (World Action Models are Zero-shot Policies)
Shenyuan Gao · NVIDIA
전체 저자
Seonghyeon Ye1, Yunhao Ge1, Kaiyuan Zheng1, Shenyuan Gao1, Sihyun Yu1, George Kurian1, Suneel Indupuru1, You Liang Tan1, Chuning Zhu1, Jiannan Xiang1, Ayaan Naveed Malik1, Kyungmin Lee1, William Liang1, Nadun Ranawaka Arachchige1, Jiasheng Gu1, Yinzhen Xu1, Guanzhi Wang1, Fengyuan Hu1, Avnish Narayan1, Johan Bjorck1, Jing Wang1, Gwanghyun Kim1, Dantong Niu1, Ruijie Zheng1, Yuqi Xie1, Jimmy Wu1, Qi Wang1, Ryan Julian1, Danfei Xu1, Yilun Du1, Yevgen Chebotar1, Scott Reed1, Jan Kautz1, Yuke Zhu1, Linxi Fan1, Joel Jang1
1NVIDIA
저자들은 사전학습된 비디오 디퓨전 모델을 기반으로 만들어 teacher-forcing 목적 함수로 미래 영상 프레임과 행동을 함께 디노이징하도록 파인튜닝한 14B 규모의 자기회귀 World Action Model, DreamZero를 소개한다. 청크 단위 자기회귀 디노이징은 KV 캐싱을 가능하게 하고 실행 중 실제 관측을 조건으로 삼을 수 있게 하며, 시스템 및 모델 최적화로 청크당 추론 시간을 5.7 s에서 0.15 s로 줄였다(GB200에서 38배 가속). AgiBot과 DROID-Franka 환경에서 크로스 임바디먼트 사전학습을 거친 모델을 포함한 VLA 베이스라인을 본 작업과 처음 보는 작업 모두에서 능가하며, 작업별 사후학습 이후에도 우위를 유지한다.
핵심 내용
여러 환경과 작업에 걸친 다양하고 반복되지 않는 데이터로 학습하면, 모델이 비디오 모델의 제로샷 일반화 능력을 물려받는다.
비디오 모델을 실시간 제어가 가능할 만큼 빠르게 만드는 것이 주된 엔지니어링 과제였다.
저자들은 영상과 행동 예측이 잘 정렬된 상태를 유지하며, 실패가 주로 영상 생성에서 비롯된다는 것을 관찰했다. 따라서 더 나은 비디오 백본이 더 나은 행동으로 이어질 것이다.
실패 데이터는 사전학습에 사용되지 않았으며, 이를 테스트 시간 적응에 활용하는 것은 향후 과제로 남겨졌다.
1Dalian University of Technology2Samsung R&D Institute China-Beijing
MemWorld는 긴 롤아웃 중 물체가 손목 카메라 시야에서 벗어났다 다시 들어올 때 행동 조건부 월드 모델이 물체를 왜곡하는 문제를 다룬다. 서펠(surfel) 기반 메모리는 장면 표면을 그것이 관측된 시점과 연결한다. 다가올 액션 청크로부터 계산한 미래 카메라 자세를 이용해 서펠을 렌더링하고 가시성, 작업 관련성, 최신성에 따라 점수를 매겨, 상위 K개의 과거 프레임을 다중 시점 월드 모델의 컨텍스트로 검색한다. 까다로운 DROID 궤적 34개에서 Ctrl-World보다 시각적 일관성이 개선되고, 실제 정책 성능을 더 가깝게 추적하며, 상상한 롤아웃을 정책 파인튜닝에 사용할 수 있다. 저자들이 이동할 수 없어 저자가 아닌 사람이 발표했으며, 질의응답은 생략되었다.
핵심 내용
미래 로봇 행동은 손목 카메라가 다음에 어디를 볼지 결정하므로, 어떤 과거 관측을 검색할지에 대한 직접적인 단서가 된다.
다섯 개 작업에서 π0와 π0.5의 월드 모델 성공률과 실제 성공률 사이의 상관계수가 0.85에서 0.97로 개선되었지만, 성공률은 여전히 과소추정된다.
작업당 선별된 성공적인 상상 롤아웃 20–30개로 π0.5를 파인튜닝하자 세 개의 장기 작업에서 평균 실제 성공률이 58%에서 72%로 올랐다.
TEMPO: 동적 로봇 조작을 위한 시간적 컨텍스트 학습 (TEMPO: Learning Temporal Context for Dynamic Robot Manipulation)
Jimin Heo, Zhenyang Feng · UC Irvine
전체 저자
Zhenyang Feng1, Jimin Heo1, Erik B. Sudderth1, Unnat Jain1
1UC Irvine
TEMPO는 걸어가는 사람에게서 병 건네받기, 떨어지는 물체 잡기, 튕긴 물체 잡기, 움직이는 바구니에 붓기처럼, 단일 프레임 VLA가 RTC 같은 지연 감소 기법을 써도 실패하는 동적 조작 작업을 겨냥한다. TEMPO는 빠져 있던 두 가지 요소를 더한다. 하나는 고정된 비디오 파운데이션 모델(기본값은 SAM 2, 프레임당 약 11 ms)이 최근 프레임에서 추출한 특징에 시간적 어텐션을 적용해 얻은 모션 토큰이고, 다른 하나는 VLM과 행동 전문가 모두에 입력되는 최근 관절 명령의 압축된 고유수용 감각 이력이다. 이 이력은 시각적으로 비슷한 상태에서 정반대의 행동이 필요한 경우를 해결한다. 모든 것이 학계 수준의 컴퓨팅으로 돌아가며, 코드와 데이터는 오픈소스로 공개되었다.
핵심 내용
추론 지연을 줄이는 것만으로는 동적 작업을 해결할 수 없다. 정책에는 물체 속도와 자신의 행동 이력도 필요하다.
병 건네받기에서 TEMPO는 기반 VLA 대비 완전한 실패를 절반으로 줄이고 성공을 거의 두 배로 늘렸다. 기반 VLA는 50회 에피소드 중 18회에서 완전히 놓쳤다.
각 요소만으로도 기반 VLA를 능가하며, 둘을 합치면 74%에 도달하고, 이 향상은 세 가지 서로 다른 VLA 백본에서 유지되었다.
동작 이해는 비디오 파운데이션 모델의 사전학습 수준에 묶여 있어, 던진 공처럼 매우 빠른 동작에서는 여전히 실패할 수 있다.
실제로 측정할 수 있는 다양성: 로보틱스 데이터셋을 위한 빠른 모델 프리 다양성 지표 (Diversity You Can Actually Measure: A Fast, Model-Free Diversity Metric for Robotics Datasets)
Sreevardhan Sirigiri · The University of Sydney
전체 저자
Sreevardhan Sirigiri1, Nathan Samuel de Lara2, Christopher Agia3, Florian Shkurti2,4, Fabio Ramos1,5
1The University of Sydney2University of Toronto3Stanford University4Allen Institute for AI5NVIDIA
저자들은 로봇 시연 데이터셋을 위한 비모수적 다양성 척도인 시그니처 엔트로피를 제안한다. 각 시연을 평탄화한 상태, 행동, (임베딩된) 관측 위의 경로로 취급하고, 시그니처 변환을 거쳐 시그니처 커널로 비교한다. 엔트로피는 커널 행렬의 고유값으로부터 닫힌 형태로 계산되며, 행렬식 기반의 부피형 대안도 있다. 또한 엔트로피를 최대화하는 부분집합을 탐욕적으로 선택하는 모델 프리 큐레이션 알고리즘 FACTUAL을 소개한다. RoboMimic에서 FACTUAL은 무작위 가지치기를 능가하고 때로는 전체 데이터셋보다도 나으며, 실제 로봇의 소형 VLA에서도 비슷한 경향이 나타난다.
핵심 내용
RoboMimic에서 시그니처 엔트로피는 정책 성공률과 강한 상관관계를 보였으며, RNN부터 디퓨전 정책까지 여러 아키텍처에서 피어슨 상관계수가 0.74에서 1 사이였다.
시그니처 변환은 길이가 서로 다른 궤적을 다루면서도 경로의 기하를 보존하여, 다루기 어려운 확률 분포를 추정할 필요를 없앤다.
FACTUAL은 보조 모델, 정책 접근, 롤아웃이 필요 없어 다른 큐레이션 방법보다 훨씬 가볍다.
시연을 추가할수록 데이터셋 엔트로피는 포화되며, 포화 속도는 기반 데이터가 얼마나 다양한지를 반영한다.
1Allen Institute for AI2TU Darmstadt3University of Washington4UCLA5Princeton University
MolmoBot은 시뮬레이션 데이터로만 학습했는데도 실제 로봇으로 제로샷 전이되는 조작 정책 계열이다. MolmoBot 엔진은 MolmoSpaces 에셋 생태계를 기반으로 장면, 물체, 수납 용기를 샘플링하고, 로봇 관절, 조명, 텍스처, 카메라를 공격적으로 무작위화하며, 재시도와 행동 노이즈를 포함한 스크립트 기반 상태 기계로 시연을 생성한다. 그 결과물인 MolmoBot 데이터는 약 94,000개 환경에 걸친 170만 개의 시연으로 구성된다. 정책들(Molmo 2 기반 MolmoBot, 경량 MolmoBot-SPOC, MolmoBot-Pi0)은 Franka DROID 환경과 RB-Y1 모바일 매니퓰레이터에서 정책당 120회의 실제 시행으로 테스트되었으며, 모든 것이 오픈소스로 공개되었다.
핵심 내용
MolmoBot-Pi0는 π0와 같은 아키텍처를 갖지만 합성 데이터로만 학습했는데도 실제 환경에서 강력한 성능을 보여, 시뮬레이션 데이터만으로도 견고한 VLA를 학습할 수 있음을 보여 준다.
저자들의 실용적 원칙은 무작위화할 수 있는 것은 모두 무작위화하라는 것이다. 공격적인 카메라 무작위화 덕분에 정책은 외부(exo) 카메라를 무시하지 않으면서도 큰 카메라 움직임에 견고해졌다.
어블레이션 결과, 데이터 규모는 일관되게 도움이 되지만 단순한 집기 작업에서 물체 클래스와 환경 다양성은 일정 수준을 넘으면 포화된다.
변형 물체는 아직 지원되지 않지만, MuJoCo의 새로운 네이티브 변형체 지원이 그 방향의 길을 연다.
로봇 조작에서 우리는 실제로 무엇을 벤치마킹하고 있는가? (What Are We Actually Benchmarking in Robot Manipulation?)
Tianchong Jiang · Toyota Technological Institute at Chicago
전체 저자
Tianchong Jiang1, Xiangshan Tan1, Samuel Wheeler2, Luzhe Sun1, Tewodros W. Ayalew3, Matthew Walter1
1Toyota Technological Institute at Chicago2Argonne National Laboratory3University of Chicago
저자들은 널리 보고되는 다섯 가지 조작 벤치마크를 검토하고, 높은 점수가 오해를 낳는 네 가지 방식을 밝힌다. 지름길, 노이즈 범위 내의 성능 향상, 작은 분포 내 변화에 대한 취약성, 그리고 일반화로 착각된 데이터상의 이점이다. 로봇 사전학습도 언어 이해도 없는 단순한 DINO+MLP 정책이 LIBERO에서 보고된 최고 결과에 거의 근접하는데, 리셋 분포가 거의 변하지 않기 때문이다. 또한 SimplerEnv와 LIBERO에서 보고된 성능 향상 중 통계적으로 유의한 것은 거의 없다. 더 넓은 학습 범위에서 테스트 자세를 샘플링하면 모든 정책의 점수가 떨어지며, 시뮬레이션 내 스크립트 시연으로 학습한 아주 작은 정책도 SimplerEnv 최고 점수에 근접한다. 저자들은 대부분의 문제를 공개되어 있고 고정되어 있으며 범위가 좁은 테스트 세트 탓으로 돌리고, 공개 이후 테스트 세트나 극도로 다양한 테스트 세트, 그리고 신뢰 구간에 대한 명시적 가이드라인을 제안한다.
핵심 내용
LIBERO와 CALVIN 같은 벤치마크는 테스트 초기 상태가 학습 시연에 거의 포함되어 있어, 어디에서 행동할지를 암기하는 것만으로 대부분 풀 수 있다.
논문들이 표준편차나 롤아웃별 결과를 거의 보고하지 않아, 작은 개선이 우연과 구별되지 않는 경우가 많다.
평가 프로토콜이 학습 데이터의 출처를 제한하지 않기 때문에, SimplerEnv 점수만으로는 real-to-sim 일반화를 보여 줄 수 없다.
공개된 고정 벤치마크는 결국 과적합되며, LLM 에이전트가 벤치마크를 상대로 반복 시도할 수 있게 된 지금은 더욱 그렇다. 따라서 비공개이거나 매우 다양한 테스트 세트가 필요하다.
실제 응용을 향한 로봇 정교한 조작의 확장 (Scaling Robotic Dexterity Toward Real-World Applications)
Wei 'Reed' Lu · Sharpa
Lu는 정교한 조작을 범용 로봇의 마지막 미해결 퍼즐 조각으로 규정하며, 그 병목은 접촉, 힘, 회복을 담아야 하는 데이터라고 말한다. 그는 Sharpa에서 추진하는 세 가지 상호 보완적 경로를 설명한다. 첫째, 하드웨어-소프트웨어 공동 설계(W2 촉각 핸드, D01 로봇, AE01 외골격 글러브, 공유 자율 원격 조작, 인간 중심 시각-촉각 데이터 수집)를 통한 데이터 소스 확장, 둘째, 시스템 1/2 정책 아래에 놓이는 빠른 촉각 '시스템 0' 상호작용 계층, 셋째, 형태 인식 토큰 공간을 통한 크로스 임바디먼트 촉각 학습이다. 그는 회사 연혁과 완전 자율 로봇 아이스크림 매장 배포 사례로 발표를 마무리한다.
핵심 내용
원격 조작 데이터는 느리고 비싸며 영상에는 접촉과 힘 정보가 없으므로, Sharpa는 어느 한쪽을 다른 쪽으로 대체하기보다 인간 중심 글러브 수집과 로봇 데이터를 결합한다.
접촉 지점 가까이의 센싱을 사용하는 저수준 상호작용 계층이 고품질 촉각 센싱이 가장 중요한 곳('마지막 1밀리미터')으로 자리매김된다.
이질적인 촉각 센서들을 형태 인식 공유 토큰 공간에 매핑하면, 하나의 촉각 전문가가 센서와 임바디먼트를 넘어 경험을 전이할 수 있다.
55단계로 이루어진 아이스크림 주문을 처음부터 끝까지 처리하는 실제 매장 배포가 전체 스택의 신뢰성을 종합적으로 검증하는 시험대로 쓰인다.
데이터와 시뮬레이션을 통한 로봇 학습의 확장 (Scaling Robot Learning Through Data and Simulation)
Christian Ureno · Lightwheel
Ureno는 1인칭 시점 인간 데이터, 물리적으로 검증된 시뮬레이션, 평가로 이어지는 Lightwheel의 로봇 정책 학습 루프를 소개한다. 그는 EgoSuite 1인칭 시점 데이터셋(10k시간 규모의 공개 릴리스로 시작해 100k시간을 향해 확장 중), 마찰, 감쇠, 그리고 케이블 같은 변형 물체를 보정하는 측정 공장을 갖춘 SimFoundry real-to-sim 파이프라인, 평가 벤치마크인 RoboFinals와 실제 산업 작업으로 구축한 새로운 RL 환경을 다룬다. 질의응답에서 그는 실제 세계에서 측정한 진동 데이터를 이용해 시뮬레이터 파라미터를 역설계한다고 설명한다.
핵심 내용
정책 학습에는 세 가지가 필요하다고 정리한다. 유용한 예시, 연습할 장소, 그리고 측정 수단이다.
케이블 같은 변형 에셋은 시뮬레이션과 실제의 진동 및 안정화 곡선을 일치시키는 방식으로 보정하여 real-to-sim 격차를 줄인다.
Lightwheel은 실제 산업 작업으로 구축한 RL 환경이 테이블탑 원격 조작 작업보다 더 가치 있다고 주장한다.
환경 구축은 에이전틱하게 이루어지며, 시뮬레이션 엔지니어가 각 단계의 물리적 충실도를 검토한다.
꿈에서 실행으로: World Action Model과 에이전틱 로보틱스 (From Dreaming to Doing: World Action Models and Agentic Robotics)
Jim Fan · NVIDIA
Fan은 강력한 프런티어 모델('Astra')의 등장이 빠른 시스템 1을 쓸모없게 만들지 않으며, 진짜 질문은 무엇이 좋고 가르칠 수 있으며 조향 가능한 기술을 만드느냐라고 주장한다. 그는 한 번의 디퓨전 패스로 미래 영상 프레임과 행동을 함께 예측하는 20억 파라미터(2B) 월드 액션 모델 GR00T 2와 엣지 컴퓨팅용 Turbo 변형을 소개하고, 데이터센터 메모리 교체나 화학 실험실 절차 같은 장기 정교한 조작 작업에서 시연한다. 그는 인간 웨어러블, 모캡 글러브, DexUMI 외골격, 시뮬레이션으로부터의 'cross adapt' 제로샷 전이를 보여 주고, 프런티어 모델을 GR00T와 결합하는 세 가지 방법(시각적 조향, 행동 편집, Aspire 에이전틱 하네스)을 제시한다. 마지막으로 모델 가중치, SimFoundry, Aspire, Flora 주석 도구 모음, 100k시간의 인간 데이터, 하드웨어 설계의 공개를 발표한다.
핵심 내용
모델은 픽셀 공간에서 미래 프레임을 '꿈꾸고' 그에 따라 행동하며, 행동과 영상을 함께 디코딩한다.
인간이 수집한 데이터(UMI 그리퍼, 모캡 글러브, DexUMI 외골격)로만 파인튜닝해도 다른 로봇 하드웨어로 제로샷 전이되었다.
픽셀 위에 가이던스를 그려 넣으면 대형 추론 모델이 작은 정책을 조향할 수 있어, 하노이의 탑 재귀 같은 인지 작업을 상위 계층으로 넘길 수 있다.
학습된 정책과 code-as-policy 회복 기술 사이를 전환하는 에이전틱 하네스 덕분에 밤새 거의 연속적인 조립이 가능했다.
NVIDIA는 GR00T 2와 Turbo 가중치, 그리고 cross-adapt 레시피를 12월에 오픈소스로 공개한다고 발표했다.
로봇은 어떻게 다른 존재와 상호작용하고 협응하는 법을 배울 수 있는가? (How Can Robots Learn to Interact and Coordinate with Others?)
Negar Mehr · UC Berkeley
Ken Goldberg의 소개로 등단한 Mehr는 두 로봇이 함께 물체를 나르는 협동 작업을 통해 상호작용 학습이 단일 에이전트 학습과 왜 다른지 보여 준다. 모방학습에 대해서는 다중 에이전트 행동 복제가 가치 격차보다 악용 가능성(exploitability)을 신경 써야 한다고 설명하고, 멀티모달 협응을 다루기 위해 분산형 디퓨전 정책을 사용하며, 고정된 단일 에이전트 정책 위에 협응을 더하는 잔차 디노이저를 학습한다. RL에 대해서는 파운데이션 모델이 작업을 분해하고 보상 및 조합 코드를 작성하며 기여도 할당을 수행하는 '코치' 역할을 하여, 일반 MAPPO로는 풀 수 없던 작업을 가능하게 한다는 것을 보인다. 마지막으로 그녀는 지속 학습을 가중치 공간에서의 시간적 합의 문제로 정식화하고 primal-dual 승수법 업데이트로 풀어, 리플레이 없이도 사전학습 작업을 잊지 않으면서 pi-0.5를 새로운 작업에 파인튜닝한다.
핵심 내용
다중 에이전트 모방에서는 한 에이전트의 작은 이탈이 공동 작업 전체를 망칠 수 있으므로, 실패 및 상호작용 모드에 대한 데이터 커버리지가 단일 에이전트 환경보다 훨씬 더 중요하다.
후퇴 지평(receding horizon) 방식으로 실행되는 분산형 디퓨전 정책은 통신 없이도 하나의 협응 모드에 암묵적으로 합의할 수 있다.
사전학습된 단일 에이전트 정책을 고정하고 적은 시연으로 협응 잔차만 학습하면, 단독 기술을 유지하면서 팀워크를 가능하게 한다.
기성 파운데이션 모델을 기여도 할당자로 사용한 방식이 창고 협응 작업에서 표준 다중 에이전트 RL 베이스라인을 능가했다.
코치가 생성한 기술 조합 코드를 반복 개선하자 휴머노이드의 버튼 누르기 성공률이 두 번의 반복 만에 약 20%에서 90%로 올랐다.
리플레이 없는 시간적 합의(TACO)는 지도 파인튜닝이 잊어버린 사전학습 작업 성능을 유지했으며, 동적 매핑에서 중복되거나 오래된 객체도 피했다.
1Institute of Computing Technology, Chinese Academy of Sciences2University of Chinese Academy of Sciences
저자들은 BitNet b1.58을 기반으로 3값(ternary) 가중치를 사용하는 완전 네이티브 1비트 VLA인 BitVLA를 소개하며, Quantize-then-Distill 단계로 비전 인코더를 압축한다. OpenVLA-OFT 수준의 조작 성능을 내면서 메모리는 11배 적게 쓰고 4.4배 빠르게 동작하며, 전용 추론 런타임과 함께 제공된다.
핵심 내용
선형 레이어를 3값 가중치와 8비트 활성화를 쓰는 레이어로 대체하면 부동소수점 곱셈-누산 연산 대부분이 사라져, 특화된 엣지 가속기의 가능성이 열린다.
전정밀도 교사 모델이 양자화된 비전 인코더의 잠재 표현을 정렬해 주면 압축 후에도 정확도를 유지하는 데 도움이 된다.
3값 가중치를 패킹한 전용 런타임은 같은 GPU에서 PyTorch보다 3.52배 빠르게 동작했다.
1Peking University2TLAIC3PrimeBot Research Institute4AIRS
저자들은 Jetson Orin 같은 저전력 온보드 장치에서의 VLA 배포를 겨냥한다. 이런 장치에서는 긴 추론 시간 때문에 인지와 실행 사이의 불일치와 느린 반응이 생긴다. 이들은 이미 확정된 행동으로부터 미래의 VLM 은닉 상태를 예측해 행동 전문가가 미래 시간 단계를 기준으로 행동하게 하고, 예측 신뢰도에 따라 VLM 호출과 행동 전문가 호출을 스케줄링하며, 온보드 추론 엔진을 추가한다.
핵심 내용
비동기 추론만으로는 지연을 숨길 수 있어도 로봇이 오래된 관측에 따라 행동하게 되는데, 미래 표현을 예측하면 이를 바로잡을 수 있다.
신뢰도 기반 스케줄링은 미래 예측이 신뢰할 만할 때 저렴한 행동 전문가만 단독으로 실행하게 하여 반응 시간을 줄인다.
실제 옷 개기 작업에서 동기식 추론 및 실시간 청킹(real-time chunking) 베이스라인보다 더 매끄러운 궤적을 보였다.
1Shanghai Jiao Tong University2PrimeBot3ShanghaiTech University4Zhejiang University5National University of Singapore
REACT는 플로 기반 VLA에서 매끄럽고 긴 액션 청크와 반응적인 재계획 사이의 트레이드오프를 다룬다. 블록들이 서로 엇갈린 디노이징 단계에 놓인 롤링 행동 버퍼를 유지하며, 새로운 관측이 들어올 때마다 이를 정제한다. 이중 분리(dual decoupling)는 센싱, VLM 인코딩, 디노이징, 실행을 비동기적으로 수행한다.
핵심 내용
더 빠른 추론이나 비동기 실행만으로는 새로운 관측이 행동에 영향을 미치는 속도인 '입력 처리량'이 높아지지 않는다.
롤링 디노이징은 실행되는 각 블록이 최근의 여러 관측에 걸쳐 정제되게 하여, 매끄러움과 반응성을 함께 개선한다.
TARC: 시간 적응형 로봇 제어 (TARC: Time-Adaptive Robotic Control)
Arnav Sukhija · ETH Zurich
전체 저자
Arnav Sukhija1, Lenart Treven1, Jin Cheng1, Florian Dorfler1, Stelian Coros1, Andreas Krause1
1ETH Zurich
TARC는 제어 업데이트 횟수에 대한 예산 아래에서 정책이 행동과 함께 그 행동을 얼마나 오래 유지할지를 출력하는 RL 프레임워크로, 이를 통해 제어 주파수 자체가 학습 대상이 된다. 4족 보행 로봇에서는 서 있을 때 제어 주기가 낮게 유지되다가 밀리면 급격히 높아지며, pi-0 VLA에서는 언제 재계획할지를 적응적으로 결정한다.
핵심 내용
이 제약 문제는 업데이트당 비용이 있는 표준 MDP로 환원되므로, 어떤 기성 RL 알고리즘이든 적용할 수 있다.
TARC는 절반 미만의 제어 주기로 고정 50 Hz 정책과 같은 성능을 냈으며, 같은 평균 주기의 고정 주기 정책은 성능이 더 나빴다.
pi-0에서의 적응형 재계획은 같은 성공률을 유지하면서 순전파(forward pass)를 약 38% 절약했다.
Diffusion ReRoll: 로봇 순차 예측을 위한 수정 가능한 디노이징 (Diffusion ReRoll: Revisable Denoising for Robotic Sequential Prediction)
Seonsoo Kim · Agency for Defense Development
전체 저자
Seonsoo Kim1, Seongil Hong1, Jun-Gill Kang1
1Agency for Defense Development
Diffusion ReRoll은 시퀀스 중 이미 안정화된 영역에 선택적으로 노이즈를 다시 주입하는 동안 다른 영역은 계속 디노이징하여, 예측 구간의 앞부분과 뒷부분이 서로를 수정할 수 있게 한다. OGBench 계획, LIBERO/RoboCasa 정책 학습, 통합 영상-행동 예측, 그리고 5 Hz 온보드 추론을 사용하는 실제 내비게이션에서 평가된다.
핵심 내용
전체 시퀀스 디퓨전은 잘못된 결정에 고착된 채 그 결정을 더 깔끔하게 만들 뿐일 수 있으며, 인과적 diffusion forcing은 뒤의 컨텍스트가 앞쪽 접두부를 수정하게 할 수 없다.
노이즈 재주입으로 얻는 이득은 재주입 횟수에 따라 커지다가 포화되며, 인과적 어텐션 마스크는 그 효과를 제한한다.
실제 내비게이션에서 전체 시퀀스 및 인과적 베이스라인이 실패한 분포 밖 레이아웃과 급회전을 처리해 냈다.
로봇 학습 파이프라인을 손상시키기 위한 월드 모델 공격 (Targeting World Models to Compromise Robot Learning Pipelines)
Ethan Rathbun · Northeastern University
전체 저자
Ethan Rathbun1, Ahmed Agha1, Saaduddin Mahmud2, Christopher Amato1, Alina Oprea1, Eugene Bagdasarian2
1Northeastern University2University of Massachusetts Amherst
저자들은 합성 로봇 학습 데이터 생성에 쓰이는 월드 모델이 은밀한 데이터 오염(poisoning)의 진입점이 된다는 것을 보인다. 안전해 보이는 시연에 눈에 띄지 않는 이미지 섭동을 가하면, 텍스트 조건부 모델에는 악성 프롬프트를 주입하고 행동 조건부 모델에는 동역학 백도어를 심을 수 있다. 오염된 롤아웃은 이후 VLA와 PPO 정책으로 전파된다.
핵심 내용
컨텍스트 프레임 하나를 섭동하는 것만으로 텍스트 조건부 월드 모델이 무해한 프롬프트로부터 전혀 다른 유해한 작업(예: 선물 상자에 무기 넣기)을 생성하게 만들 수 있었다.
백도어는 에이전트가 트리거를 보았을 때 목표 행동을 취하지 않으면 월드 모델의 예측이 붕괴되게 만들며, RL 정책은 결국 그 행동을 학습한다.
저자들은 이것이 월드 모델만을 공격해 주입한 최초의 백도어 공격이라고 밝히며, 더 안전한 월드 모델 공급망을 촉구한다.
청크 단위 모델 기반 정책 최적화 (Chunk-wise Model-based Policy Optimization)
Weixi Song · Zhejiang University / Shanghai Innovation Institute / Westlake University (녹화에서 발표자가 언급되지 않아 제1저자를 표시)
전체 저자
Weixi Song1,2,3, Donglin Wang3, Yong-Lu Li2,4
1Zhejiang University2Shanghai Innovation Institute3Westlake University4Shanghai Jiao Tong University
저자들은 순환적 월드 모델 롤아웃을 청크 월드 모델로 대체한다. 이 모델은 잠재 상태와 예측된 액션 청크를 한 번의 패스로 미래의 잠재 청크에 매핑하며, 시간 역전파(backpropagation through time) 없이 가치 확장(value expansion)을 최적화한다. HumanoidBench에서 평가하고, Unitree Go2 사족 보행 로봇에 이족 보행을 배포했다.
핵심 내용
청크 수준 예측은 한 스텝 오차의 누적과 순환 롤아웃을 통한 그래디언트의 불안정성을 피한다.
HumanoidBench에서 TD-MPC2 대비 약 50%의 학습 시간과 30배 빠른 추론으로 강력한 성능에 도달했다.
FedGuide: 이질적 연합 강화학습을 위한 디퓨전 사전분포 정렬과 가치 기준선 가이던스 (FedGuide: Diffusion Prior Alignment and Value Baseline Guidance for Heterogeneous Federated Reinforcement Learning)
Zhilin He · Carnegie Mellon University
전체 저자
Zhilin He1, Gauri Joshi1
1Carnegie Mellon University
FedGuide는 동역학, 보상, 초기 상태가 서로 다른 클라이언트 간의 연합 RL 문제를 다룬다. 최적 수송(optimal transport) 기반 전문가 혼합(mixture of experts)으로 집계되는 개인화된 디퓨전 사전분포를 사용하고, 사전분포로 정규화된 PPO를 안정화하기 위해 DICE 가치 기준선을 더한다. MuJoCo 보행 과제와 Meta-World 조작 과제에서 평가했다.
핵심 내용
로컬 정책을 단순 평균하면 각 이질적 클라이언트에 필요한 특화된 행동 모드가 지워진다.
행동 사전분포를 분포 공간에서 집계하자 여러 보상 모드가 보존된 반면, 정책 평균은 하나의 모드로 붕괴했다.
DICE 가치 기준선 덕분에 학습 라운드 전반에서 리턴의 변동성이 크게 낮아진 것으로 나타났다.
MoRE: 다중 물리 로봇 월드 모델을 위한 전문가 혼합(Mixture-of-Experts) (MoRE: Mixture-of-Experts for Multi-Physics Robotic World Models)
Ziyu Zhu · UIUC / Georgia Tech
전체 저자
Ziyu Zhu1,2, Shaowei Liu1, Albert J. Zhai1, Henry Che1, Wei-Chiu Ma3, Shenlong Wang1
1UIUC2Georgia Tech3Cornell University
MoRE는 3D 포인트 기반 월드 모델로, 공유 인코더 위에서 로봇 상호작용을 강체, 변형체, 파지(prehensile) 동역학을 담당하는 모션 전문가로 라우팅하며, Isaac Sim 데이터와 실제 데이터로 학습된다. MPC와 통합하면 하나의 모델로 실제 로봇에서 강체 상자를 밀고, 부드러운 천을 조작하며, 다단계 도구 사용을 수행한다.
핵심 내용
하나의 공유 동역학 모델은 서로 다른 상호작용 양상을 뭉개는 경향이 있으며, 라우터를 갖춘 전문가 혼합은 이를 피한다.
MoRE는 강체, 변형체, 파지 벤치마크 전반에서 기존 방법보다 예측 정확도를 높였다.
MPC 안에서 하나의 월드 모델을 사용해 재료별 모델 없이도 다양한 실제 조작 과제가 가능해졌다.
체화된 AI(Embodied AI) 실현을 위한 과제 (Challenges to Realize Embodied AI)
Wolfram Burgard · University of Technology Nuremberg
Dieter Fox의 소개로 등장한 Burgard는 로봇 연구를 확률론적 로보틱스, 딥러닝, 그리고 이제 파운데이션 모델이라는 세 가지 기술로 바위를 거듭 언덕 위로 밀어 올리는 시지프스에 비유한다. 그는 확률론적 방법이 밀리미터 수준의 위치 추정과 자율주행차의 부상을 이끌었다고 평가하면서도, HD 맵에 대한 의존이 시스템을 지오펜스된 레벨 4 자율주행에 묶어 두고, 사전 정의된 온톨로지를 필요로 하는 딥러닝은 어수선한 가정 환경에서 무너진다고 주장한다. 이어 자신의 연구 그룹이 수행한 파운데이션 모델 연구, 즉 맵 없는 내비게이션(FlowNav, MetricNet), LLM으로 연결한 스킬, 의미론적 파지, 촉각 예측, 명시적 렌치 제어, 비전-언어 내비게이션 에이전트의 해석 가능성을 개관한다. 마지막으로 보정된 불확실성, 로봇 파운데이션 모델에서의 힘과 촉각, 공유 대규모 학술 컴퓨팅 자원, 그리고 '로보틱스의 CERN'을 촉구한다.
핵심 내용
딥 인식과 확률론적 상태 추정을 결합하려면 보정된 불확실성이 필요하며, 파운데이션 모델에서는 이것이 더욱 어려워진다.
Burgard는 자율주행이 더 구조화된 환경에서 성공한 것처럼, 로봇이 어수선한 가정보다 공장 현장에 훨씬 먼저 도달할 것으로 예상한다.
맵 없는 내비게이션에도 어느 정도의 계량적 기하 정보가 필요하다. 스케일 없는 디퓨전 기반 내비게이션은 충돌을 일으켰고, MetricNet의 스케일이 반영된 웨이포인트가 이를 해결했다.
모방 정책에 명시적 힘/렌치 제어를 추가하자 위치+강성 제어보다 접촉이 많은 과제의 성능이 크게 향상되었다.
최신 비전-언어 내비게이션 에이전트는 사람이 주석한 관련 영역 대비 정밀도가 70% 미만이었으며, 이는 해석 가능성 연구가 더 필요함을 보여 준다.
그는 산업계를 따라잡기 위해 학계가 힘과 촉각을 포함한 개방형 로봇 파운데이션 모델에 자원을 모아야 한다고 주장한다.
Harris는 GM이 Cruise 로보택시 프로그램에서 개인용 자율주행으로 전환했으며, 2028년 아이즈오프(eyes-off) 고속도로 제품을 목표로 한다고 설명한다. 그는 실제 시간보다 50,000배 이상 빠르게 돌아가는 시뮬레이터에서의 셀프 플레이 RL(인간 성능을 넘어서고 복구를 학습하지만, 단순화된 입력을 사용하며 인간처럼 느껴지지 않을 수 있음)을 수십만 시간 분량의 주행 로그에 대한 모방학습과 대비한다. 둘을 결합하는 방법을 개략적으로 제시하고, 장면 추론, 데이터 마이닝, 분류(triage), 비평 등 차량 탑재 및 오프보드 VLM 활용을 소개한다.
핵심 내용
GM의 고속 시뮬레이터에서 2시간 미만의 셀프 플레이 학습만으로 견고한 합류 및 양보 행동이 나타났다.
셀프 플레이는 드문 사건에 대한 커버리지를 제공하고 DAgger의 오차 누적 문제를 피하며, 모방은 현실적인 분포와 인간다운 행동을 제공한다.
가능한 결합 방식으로는 RL을 모방 정책에 고정(anchor)하기, RL 교사를 증류하기, 인간 주행으로부터 보상 학습하기 등이 있다.
VLM은 사고 현장에서의 차선 수준 고차원 추론과 도로 위 잔해 같은 드물고 비정형적인 사건의 마이닝에 유용하다.
Cho는 실세계 데이터를 크라우드소싱하려는 BitRobot의 목표를 소개한다. 여기에는 6개 카메라로 구성된 머리 장착형 캡처 장치 RoboCap, 무선 동기화 손목 카메라, 촉각 장갑 통합, 그리고 RoboCap 10K, LiDAR 정답 데이터셋, 대규모 도시 내비게이션 데이터셋, 실제 가정에서의 휴머노이드 500시간 데이터 같은 공개 데이터셋이 포함된다. 이어 Duan은 수백 대의 로봇, 30명의 평가 팀, 수백 개의 환경을 갖춘 대규모 실세계 평가 프로젝트 RoboColosseum을 소개하며, 파인튜닝 트랙과 오픈 트랙을 제공한다.
핵심 내용
RoboCap 10K는 11개국에서 수집한 10,000시간 분량의 실제 환경 직업 작업 데이터를 손 포즈 및 SLAM 정보와 함께 제공한다.
RoboColosseum의 첫 평가에서 모든 설정을 지배하는 모델은 없었고, 완전한 성공에 도달한 휴머노이드 모델도 없었다.
Duan에 따르면 모델에 대해 통계적으로 유의한 결론을 내리려면 약 400~500회의 비교가 필요하다.
피지컬 AI를 위한 데이터 인프라 (Data Infrastructure for Physical AI)
Kun Wang · MaxInsights
MaxInsights의 공동 창업자 겸 CTO는 회사를 로봇 학습용 1인칭 시점 인간 데이터의 대형 공급자로 소개하며, 지금까지 200만 시간 이상을 납품했다고 밝힌다. 그는 데이터 품질에 대한 내부 근거로, 1인칭 데이터만으로 사전학습한 모델이 약 10배 많은 혼합 데이터로 학습한 모델과 비슷한 성공률에 도달했다는 결과를 공유하고, 손별·단계 수준 라벨을 갖춘 세밀한 언어 주석 체계를 소개한다. 또한 공개 주석 데이터셋과 실제 환경 평가 및 교정 피드백 루프를 예고한다.
핵심 내용
자사 1인칭 데이터 약 600시간으로 사전학습한 결과가, 시뮬레이션에서 로봇 데이터와 1인칭 데이터를 합쳐 6,000시간 이상 학습한 기준선과 대략 비슷한 것으로 보고되었다.
언어 주석은 목표 명확성, 시간적 일관성, 실행 세부사항을 중심으로 구성되며, 왼손과 오른손을 따로 약 1초 단위로 라벨링한다.
MaxInsights는 기존 1인칭 데이터셋에 없다고 하는 손가락 수준 접촉 라벨을 포함한 주석 데이터셋을 오픈소스로 공개할 계획이다.
결과를 확인하고 정책에 교정 피드백을 보내는 추론 모델이 실세계 데이터 피드백 루프의 일부를 이룬다.
Ego2Robot: 1인칭 시점 인간 데이터로부터의 확장 가능한 로봇 데이터 합성 (Ego2Robot: Scalable Robot Data Synthesis from Egocentric Human Data)
Ye Wang · Renmin University of China / Alibaba Inc. (녹화에서 발표자가 언급되지 않아 제1저자를 표시)
전체 저자
Ye Wang1,2, Pei Lin2,3,4, Xiong-Hui Chen2, Haoqi Yuan2, Zhixuan Liang2, Yiyang Huang2, Anzhe Chen2, Zixing Lei2, Jie Zhang2, Tao Zhang1, Haoyang Li2, Tong Zhang2, Chenxi Xiao3, Ziyuan Jiao4,5, Qin Jin1
1Renmin University of China2Alibaba Inc.3ShanghaiTech University4Beijing Institute for General Artificial Intelligence5Beihang University
저자들은 1인칭 시점의 인간 조작 영상을 로봇 학습 데이터로 변환하는 파이프라인 Ego2Robot을 제시한다. 손 포즈를 그리퍼 동작으로 리타기팅하고, 사람의 팔을 인페인팅으로 지우고, 시뮬레이션에서 동작을 재현한 뒤 렌더링된 로봇을 원래 장면에 합성하고, 저품질 클립을 걸러 낸다. 확장된 RoboTwin 벤치마크를 사용해 이 합성 데이터가 외관, 장면 배치, 임바디먼트, 과제 의미라는 축에서 로봇 파운데이션 모델의 사전학습에 얼마나 도움이 되는지 측정한다.
핵심 내용
합성된 Ego2Robot 데이터와 실제 로봇 데이터를 균형 있게 섞는 것이 사전학습에 가장 효과적이며, 원시 1인칭 영상을 섞는 것보다 로봇 형식으로 합성된 데이터를 섞는 편이 낫다.
가장 큰 향상은 조명 및 로봇 색상 변화, 카메라 이동에 대한 견고성, 크로스 임바디먼트 전이, 처음 보는 물체가 포함된 지시에서 나타나며, 로봇 신체 종류를 늘릴수록 전이가 계속 개선된다.
1Shanghai Jiao Tong University2Eastern Institute of Technology, Ningbo3Peking University4ShanghaiTech University
저자들은 인간의 시선을 임바디먼트에 무관한 의도 신호로 사용한다. 손과 시선이 주석된 대규모 1인칭 데이터셋으로 사전학습한 모델이 먼저 의도 토큰을 자기회귀적으로 예측한 다음, 사고의 사슬(chain-of-thought) 방식으로 행동을 생성한다. 사후학습에는 시선 주석이 없는 소량의 로봇 데이터와 해당 과제의 인간 데이터만 있으면 된다.
핵심 내용
고수준 의도는 저수준 행동보다 임바디먼트 간 전이가 훨씬 쉬우므로, 인간에서 로봇으로의 전이를 잇는 다리 역할을 한다.
예측된 의도를 수동으로 편집하면 로봇의 궤적이 즉석에서 바뀌며, 의도를 모델링하면 과제 성공률이 높아진다.
인간 데이터는 사전학습과 사후학습 모두에 도움이 되며, 인간 영상에서만 본 시나리오에서도 로봇이 성공하게 해 준다.
Real-to-Sim-to-Real 공유 자율성을 통한 효율적이고 신뢰성 높은 원격 조작 (Efficient and Reliable Teleoperation through Real-to-Sim-to-Real Shared Autonomy)
Shuo Sha · Columbia University
전체 저자
Shuo Sha1, Yixuan Wang1, Binghao Huang1, Antonio Loquercio2, Yunzhu Li1
1Columbia University2University of Pennsylvania
저자들은 real-to-sim-to-real 공유 자율성 프레임워크를 제안한다. 5분 미만의 실제 원격 조작 데이터에 맞춘 k-최근접 이웃 인간 대리 모델을 상대로 시뮬레이션에서 학습한 잔차(residual) RL 보조 조종사(co-pilot)가 너트 체결, 기어 맞물림, 페그 삽입 같은 접촉이 많은 과제에서 조작자를 돕는다. 사람은 고수준 의도를 제공하고 보조 조종사는 저수준 접촉 정렬을 담당한다.
핵심 내용
사람이 의도를 제공하고 RL이 저수준 접촉 제어를 담당하도록 역할을 나누면, 완전한 자율성을 해결하지 않고도 원격 조작의 신뢰성이 높아진다.
보조 조종사가 지원하는 원격 조작은 성공률을 높이고 완료 시간과 작업 부하를 줄이며, 삽입 속도 조절 같은 조작자의 의도를 따른다.
보조 조종사 지원 시연으로 학습한 디퓨전 정책은 같은 양의 직접 원격 조작 데이터로 학습한 정책보다 우수하다.
1Microsoft Research2University of Washington3Microsoft4ETH Zurich
Michael Murray는 FlowDAgger를 소개한다. 이 방법은 소수의 사람의 스페이스 마우스 교정만으로 작은 잠재 조향(latent-steering) 정책을 학습해, 고정된 플로 매칭 및 디퓨전 정책(pi0.5, Cosmos Policy, 일반 디퓨전 정책 등)을 적응시킨다. 핵심 요소는 행동 역변환(action inversion)으로, 고정점 최적화를 통해 각 교정을 그것을 만들어 낼 노이즈 잠재 변수로 되돌리며, 이를 DAgger 방식의 루프 안에서 사용한다.
핵심 내용
역변환된 교정으로 잠재 공간을 직접 지도하면 수십 에피소드 만에 진전이 생기는 반면, 노이즈 공간을 탐색하면 수천 에피소드가 걸릴 수 있다.
작은 잠재 정책만 학습하므로 사전학습된 사전 지식을 보존하고 지도 파인튜닝에서 나타나는 파국적 망각을 피하며, 소비자용 GPU에서 실행된다.
1Sun Yat-sen University2Tsinghua University3Peking University4Jiangxing Intelligence (Guizhou) Technology Inc.5Stanford University
저자들은 양손 정교한(덱스터러스) 파지 합성 파이프라인이자 생성 모델인 BiDexGrasp를 소개한다. 영역 기반 초기화와 분리된 최적화로 합성 속도를 40배 높여 거의 1,000만 개에 달하는 파지 데이터셋을 만들었으며, 양손 협응 모듈과 물체 적응형 파지 앵커로 협응과 큰 크기 변화를 처리한다.
핵심 내용
두 손을 유망한 영역에서 초기화하고 최적화를 분리하면 양손 파지 합성이 훨씬 효율적이 되어, 기준선의 합성 성공률을 두 배 이상으로 높인다.
학습된 생성기는 기준선 대비 성공률을 약 25%p 향상시킨다.
실제 실험에서 30개 물체에 대한 260회 시행에서 74.6%의 성공률을 달성했으며, 다른 로봇 손으로의 전이도 포함한다.
WM-Craftnet: 견고하고 일반화 가능한 손 안 정교한 조작을 위한 월드 공감각(Synesthesia) 모델 (WM-Craftnet: World Synesthesia Model for Robust and Generalizable Dexterous In-Hand Manipulation)
Xiaojing Tan · Sharpa Robotics
전체 저자
Jie Yin1, Zeyuan Zhao1, Xiaojing Tan1, Yang Liu1, Chiyu Wang1, Xinyang Gu1
1Sharpa Robotics
WM-Craftnet은 20-DoF 휴머노이드 손을 위해 깊이, 촉각, 고유수용 감각, 과거 행동, 보상을 입력으로 Dreamer 방식의 순환 상태 공간 월드 모델을 학습한다. 노이즈가 섞인 센서로부터 깨끗한 깊이를 복원하도록 학습된 잠재 상태는 상상(imagination)에 쓰이는 대신 폐루프 손 안 회전 정책의 조건으로 사용된다.
핵심 내용
깨끗한 깊이 복원은 노이즈가 섞인 센싱을 정규화하여 sim-to-real 견고성을 높이며, 배포 시에는 원시 센서만 사용한다.
단 9개 물체로 사전학습한 월드 모델이 재사용 가능한 사전 지식 역할을 하여, 하위 정책이 물체 식별자나 특권 정보 없이 49개 물체로 일반화하게 해 준다.
순환 이력이 현재 접촉 상태를 추정하여, 외란으로부터의 복구와 어려운 초기 파지에서의 재중심화를 가능하게 한다.
1Zeno AI2The University of Sydney3Zhejiang University
저자들은 한 명의 원격 조작자가 두 대의 양팔 모바일 매니퓰레이터를 위한 결합된 정책을 학습시킬 수 있게 하는 Sequential Asymmetric Imitation(SAI)을 제안한다. 먼저 로봇 A를 사람 파트너와 함께 학습시키고, 이어 로봇 B를 A의 고정된 정책과 함께 가르친 다음, A가 기다리거나 양보하거나 복구해야 하는 상황의 교정으로 A를 파인튜닝한다. 과제로는 식탁보 펼치기와 그림을 똑바로 세우기 등이 있다.
핵심 내용
학습된 파트너를 교육 과정의 일부로 포함하면, 동기화된 2인 조작자 시연 없이도 B가 A의 실제 타이밍과 실수에 적응할 수 있다.
SAI는 같은 아키텍처와 예산으로 독립적으로 학습한 모방 정책을 능가하며, 이는 주로 언제 기다려야 하는지와 공동 지지를 어떻게 유지하는지를 학습한 덕분이다.
메시지 전달 기준선은 통신이 안정적일 때는 잘 작동하지만 지연과 패킷 손실 상황에서는 성능이 저하된다.
처음보다 더 낫게 남겨 두기: 순차적 과제에서의 가치 기반 협력 (Leave It Better Than Found: Value-Guided Cooperation in Sequential Tasks)
Mario Gomez Andreu · University of Cambridge / ETH Zurich
전체 저자
Mario Gomez Andreu1,2, Michael Amir1, Antonio Marino1, Tianxu An2, Marco Hutter2, Amanda Prorok1
1University of Cambridge2ETH Zurich
Mario Gomez Andreu는 순차적 과제 이어받기를 위한 애드혹 방법 PAVE를 소개한다. 리더 로봇은 자신의 정책을 사전분포로 사용하면서, 자신의 목표와 인계 시점 상태에서의 팔로워 가치 함수 사이의 트레이드오프를 온라인으로 최적화한다. 분포 외(out-of-distribution) 지표는 팔로워가 학습 중 본 적 없는 상태에서 리더가 팔로워의 가치를 신뢰하지 않도록 막는다.
핵심 내용
RL 팔로워의 기존 가치 함수를 공유하면 공동 학습 데이터 없이도 협력이 가능하며, 이는 로봇의 제조사가 서로 다를 때 중요하다.
팔로워의 가치 추정은 분포 밖에서 과신하는 경향이 있으므로, OOD 지표로 이를 걸러 내는 것이 필수적이다.
이 방법은 리더의 성공률을 높게 유지하면서 팔로워의 성공률을 약 28%p 높이며, 특권 정보를 쓰는 파인튜닝 기준선과 대등한 성능을 낸다.
화 9:00 AM · Hilton Austin · 좌장: Katerina Fragkiadaki
3개 발표
구두 발표
RL Token: 비전-언어-행동 모델로 온라인 RL 부트스트래핑하기 (RL Token: Bootstrapping Online RL with Vision-Language-Action Models)
Charles Xu · Physical Intelligence
전체 저자
Charles Xu1, Jost Tobias Springenberg1, Michael Robert Equi1, Ali Amin1, Adnan Esmail1, Sergey Levine1, Liyiming Ke1
1Physical Intelligence
Charles Xu는 Physical Intelligence의 RL Token을 소개한다. 이 방법은 pi0.6 VLA를 조정해 하나의 압축된 'RL 토큰'을 노출시키는데, 이 토큰은 최종 레이어 임베딩 전체를 복원해야 하는 인코더-디코더를 통해 학습되며, 작은 온라인 액터-크리틱의 관측값으로 쓰인다. 액터는 VLA가 샘플링한 액션 청크를 조건으로 받고 그쪽으로 정규화되며, 사람의 성공 라벨과 개입을 활용한 온라인 RL은 드라이버 맞추기나 케이블 타이 끼우기처럼 과제에서 가장 어려운 부분만을 겨냥한다.
핵심 내용
VLA의 사전학습된 임베딩은 소형 네트워크 RL의 인식 백본으로서 범용 인코더보다 훨씬 낫다. 어블레이션에서 ResNet-10을 RL 토큰으로 바꾸자 하위 RL 속도가 약 두 배가 되었다.
가우시안 RL 액터를 VLA의 행동 제안에 조건화하면 멀티모달 플로 정책의 평균으로 붕괴하는 것을 피하고 학습이 쉬워진다.
이더넷 삽입 과제에서 RL 정책의 에피소드 중앙값은 66스텝으로, SFT의 230스텝, 숙련된 원격 조작자의 약 150스텝과 대비되며, 에피소드의 절반은 가장 빠른 원격 조작 에피소드보다 빨랐다.
과제의 병목에 집중한 온라인 RL은 VLA 전체에 대한 반복적 RL에 필요한 며칠이 아니라 몇 시간이면 된다.
1Amazon FAR2UC Berkeley3Stanford University4The University of Hong Kong5Carnegie Mellon University
Hongsuk Choi는 FPO++를 소개한다. 이 방법은 두 가지 변경을 통해 플로 매칭 정책 그래디언트 RL(FPO)을 로봇 제어에서 안정적으로 만든다. 하나는 각 노이즈 타임스텝 비율을 클리핑하는 샘플별 신뢰 영역이고, 다른 하나는 양의 어드밴티지에는 PPO 클리핑을 유지하고 음의 어드밴티지에는 SPO를 사용하는 비대칭 신뢰 영역이다. 이 방법으로 보행과 휴머노이드 모션 트래킹을 처음부터 학습해 실제 로봇에 배포했으며, 이미지 기반 조작 정책도 파인튜닝했다.
핵심 내용
기존 FPO는 복잡한 로보틱스 과제에서 붕괴했지만, 샘플별 클리핑과 비대칭 신뢰 영역을 더하면 시드와 임곗값 전반에서 일관되게 높은 리턴을 얻는다.
음의 어드밴티지를 가진 행동으로부터 플로를 밀어내면 ELBO 사후분포 격차가 커질 수 있는데, SPO 방식의 정규화가 이를 막는다.
플로 정책은 의미 있는 관절 간 상관관계를 학습하고 가우시안 PPO보다 탐색을 더 오래 유지하여, 더 자연스러운 보행을 만들어 낸다.
추론 시 노이즈 없는 샘플링은 적은 적분 스텝에서도 더 부드럽고 신뢰성 높은 행동을 낸다.
빠르게 달릴까, 느리게 달릴까? 멀티모달 지상 이동체의 모션 예측을 위한 뉴로-심볼릭 가이던스 (Driving, Fast or Slow? Neuro-Symbolic Guidance for Motion Prediction in Multi-Modal Ground Mobility)
Simon Kohaut, Felix Divo · TU Darmstadt
전체 저자
Simon Kohaut1, Felix Divo1, Julius Hahnewald1, Benedict Flade2, Julian Eggert2, Kristian Kersting1,3,4,5, Devendra Singh Dhami6
1TU Darmstadt2Honda Research Institute3hessian.AI4Centre for Cognitive Science5DFKI6TU Eindhoven
Simon Kohaut와 Felix Divo는 TraCS(Trajectory Compliance-Shaping)를 소개한다. 이 방법은 블랙박스 모션 예측기의 제안을 지역 교통 규칙에 대한 확률적 1차 논리 모델과 로그-선형 의견 풀(log-linear opinion pool)로 융합하며, 학습된 신뢰 게이트가 규칙을 언제 적용할지 결정한다. 코더, 심사자, 검증자로 구성된 에이전트 루프가 자연어 교통 규칙을 수 밀리초 안에 평가할 수 있는 Resin 확률 논리 프로그램으로 변환한다.
핵심 내용
코딩 에이전트로 쓰인 프런티어 LLM은 규칙 텍스트를 올바른 프로그램으로 변환했으며, 더 약한 모델일수록 심사자와 검증자의 역할이 더 중요했다.
QCNet, DeMo 등 여러 백본을 사용한 Argoverse 2 실험에서 전체 향상 폭은 작지만, 오차가 가장 큰 꼬리 구간, 특히 보행자에 집중된다.
규칙을 항상 적용하거나 학습된 신뢰 가중치를 섞어 버리면 도움이 되지 않으므로, 에이전트가 언제 규칙을 따르는지 아는 것이 규칙 자체만큼 중요하다.
준수 지형(compliance landscape)이 표시한 규칙 위반과 오예측은 향후 데이터 수집의 방향을 잡는 데 활용될 수 있다.
화 9:30 AM · Hilton Austin · 좌장: Georgia Chalvatzaki
1개 발표
신진 연구자 기조연설
처음부터 다시 시작하지 않는 학습: 로봇이 실세계에서 배울 수 있는 것의 확장 (Learning Without Starting Over: Expanding What Robots Can Learn in the Real World)
Roberto Martin-Martin · University of Texas at Austin
Georgia Chalvatzaki의 소개로 등장한 Martin-Martin은 어떤 로봇도 모든 미래에 대비해 사전학습될 수는 없으므로, 중요한 것은 로봇의 '학습 잠재력', 즉 제한된 실세계 경험으로부터 얼마나 많은 새로운 능력을 얻는가라고 주장한다. 아기가 두드리기에서 망치질로 나아가는 실험에서 출발해, 사전 지식을 재사용하는 방식이 이후에 무엇을 학습할 수 있는지를 결정한다는 것을 보여 준다. 이어 안전한 실세계 RL을 위한 학습된 행동 공간(SLAC, 모드 인덱스 디퓨전 정책), 인간 시연과 교정으로부터의 구조 추출(SafeMimic, OopsieVerse 손상 시뮬레이션, Oopsie-Recover), 어떤 데이터로 학습하거나 수집할지의 선택(DataMIL, GUILD)에 관한 연구실의 연구를 개관한다. 마지막으로 경험 로그, 근거 있는 인간 피드백, LoRA로 적응시킨 VLA를 통한 메모리와 지속 학습을 다룬다.
핵심 내용
자기지도 방식으로 학습한 두드리기 스킬을 파인튜닝하면 처음부터 학습하는 것보다 망치질을 더 빨리 배우고, 고정하면 가장 빨리 배우지만 정체되므로, 재사용의 형태가 사전 지식만큼 중요하다.
시뮬레이션에서 학습한 과제 무관·안전 편향 잠재 행동 공간 덕분에 모바일 매니퓰레이터가 1시간 미만의 실세계 RL로, 안전 중단이 거의 없이 접촉이 많은 과제를 학습했다.
언어로 주석된 소수의 교정을 게이트가 있는 프로그램형 비용으로 바꾸자 고정된 VLA가 약 35%, 새로운 상황에서는 약 20% 개선되었다.
대상 정책에 미칠 예측 효과를 기준으로 공동 학습 데이터를 선택하는 방식은 이미지나 언어 유사도 휴리스틱보다 낫고, Open X-Embodiment에 없는 로봇에도 도움이 된다.
온폴리시 RL과 순차적 LoRA 어댑터를 사용하면 VLA가 평균 망각이 거의 0에 가까운 상태로 새로운 스킬을 얻을 수 있어, 지속 학습을 위한 유망한 기반이 된다.
학습된 안전성은 형식적 보장이 아닌 확률적 보장을 제공하므로, 향후 평가는 정책이 얼마나 안전한지를 테스트하는 데 의존하게 될 것이다.
Ruijie Zheng은 EgoScale을 소개한다. 이 방법은 SLAM과 손 포즈 추정으로 행동으로 변환되고 22-DoF Sharpa 손에 리타기팅된 대규모 1인칭 시점 인간 영상으로 GR00T 방식의 VLA를 사전학습한 뒤, 정렬된 인간 및 로봇 데이터(같은 과제에 대한 약 4시간의 원격 조작 데이터와 장갑 및 손목 카메라로 추적한 50시간의 인간 데이터)로 중간 학습을 하고, 새로운 정교한 과제에 대해 사후학습한다.
핵심 내용
인간 데이터 사전학습과 정렬된 중간 학습을 결합하면 5개의 정교한 과제에서 가장 높은 성공률을 얻으며, 병뚜껑 열기나 주사기 옮기기 같은 가장 어려운 과제에서 의미 있는 성공을 거두는 것은 이 조합뿐이다.
인간 검증 손실은 인간 데이터 양에 대해 로그-선형 스케일링 법칙을 따르며, 실제 로봇 성능과 상관관계가 있다.
원샷 전이가 나타난다. 셔츠 개기 같은 새로운 과제를 단 하나의 원격 조작 궤적과 약 100개의 인간 시연만으로 학습한다.
같은 레시피가 다른 손을 가진 Unitree G1에도 전이되며, 기준선보다 더 부드러운 동작을 보인다.
1Peking University2PrimeBot3Beijing Institute for General Artificial Intelligence
OpenDexGrasp는 자유 형식의 언어 지시로부터 과제 지향적인 정교한 파지를 생성한다. OpenDex-Scale(VLM이 과제 설명으로 라벨링한 124만 개의 합성 파지)과 OpenDex-Align(물체 인스턴스 간에 전이된 약 27k개의 인간 시연 기능적 파지)을 결합하고, 사전학습된 VLM과 3D 기하 인코더를 결합해 과제 어포던스와 손 포즈를 함께 예측하는 모델을 사용한다.
핵심 내용
폭넓은 합성 데이터 커버리지와 더 작은 규모의 고품질 인간 정렬 데이터를 짝지으면 물리적 파지 품질과 기능적 파지 품질이 모두 향상된다.
파지와 함께 어포던스를 예측하면 언어 지시와 손이 접촉해야 할 위치가 연결된다.
어블레이션에서 사전학습된 VLM 백본을 교체했을 때 가장 큰 성능 하락이 나타났으며, 실제 로봇 파지는 72%의 확률로 성공한다.
Play2Perfect: 정밀 조립을 위한 정교한 플레이 사전학습에서 무엇이 중요한가? (Play2Perfect: What Matters in Dexterous Play Pretraining for Precise Assembly?)
Tyler Ga Wei Lum, Kushal Kedia · Stanford University / Cornell University
전체 저자
Tyler Ga Wei Lum1, Kushal Kedia2, Karen Liu1, Jeannette Bohg1
1Stanford University2Cornell University
Tyler Lum과 Kushal Kedia는 Play2Perfect를 소개한다. 다지 로봇 손을 먼저 수천 개의 무작위 물체로 무작위 6D 목표 자세에 도달하는 '플레이'를 통해 RL로 사전학습한 뒤, 0.5mm 삽입이나 테이블 다리 나사 조이기 같은 정밀한 장기 조립 과제를 위해 CAD로 정의한 희소 보상으로 파인튜닝한다. 정책은 전적으로 시뮬레이션에서 학습되며, FoundationPose 물체 추적과 함께 제로샷으로 배포된다.
핵심 내용
플레이 사전학습을 거치면 조립 과제가 2~5시간의 파인튜닝 안에 높은 성공률에 도달하는 반면, 처음부터 하는 RL은 24시간 후에도 0%에 머물고, 조밀 보상 RL은 같은 수준에 이르는 데 33배 더 오래 걸린다.
플레이 사전학습 정책은 여러 손가락으로 파지하고 힘 외란 하에서도 80% 이상의 성공률을 유지하는 반면, 조밀 보상 RL은 쉽게 실패하는 취약한 전략을 학습한다.
효과적인 플레이에는 완전한 6D 목표(병진만이 아닌), 1 cm의 엄격한 허용 오차, 많은 물체, 매 에피소드 새로운 무작위 목표가 필요하며, 이 모두가 손 안 조작을 강조한다.
플레이만으로는 자유 공간 동작은 처리하지만 접촉에서는 실패한다. 파인튜닝은 접촉이 많은 탐색 전략을 가르치며, 작은 물체는 가림 때문에 여전히 어렵다.
FACTR 2: 범용 로봇 팔을 위한 외력 감지 학습이 정책 학습을 개선한다 (FACTR 2: Learning External Force Sensing for Commodity Robot Arms Improves Policy Learning)
Jason Jingzhou Liu, Steven Oh · Carnegie Mellon University / Waseda University
전체 저자
Steven Oh1,2, Jason Jingzhou Liu1, Tony Tao1, Philip Han1, Kenneth Shaw1, Satoshi Funabashi2, Ruslan Salakhutdinov1, Deepak Pathak1
1Carnegie Mellon University2Waseda University
Jason Liu와 Steven Oh는 NEXT를 통해 저가형 로봇 팔에 외력 감지 기능을 부여하는 FACTR 2를 소개한다. 약 10분 분량의 자유 공간 관절 위치, 속도, 모터 전류로 약 1분 만에 학습한 LSTM이 자유 공간 토크를 예측하므로, 접촉 중의 잔차가 곧 외부 토크가 된다. 이 추정값은 Piper, YAM, Nero 같은 팔에서 힘 피드백 원격 조작을 구동하며, FIRST는 이를 이용해 시연을 자유, 접촉 전, 접촉 단계로 분할하고 행동 복제 학습 시 뒤의 두 단계를 업샘플링한다.
핵심 내용
Franka에서 NEXT의 추정값은 접촉 중에는 내장 토크 센서 값을 잘 따라가고, 자유 동작 중에는 0 근처에 머문다.
외부 토크를 정책 입력으로 쓰는 동시에 접촉 전 및 접촉 구간을 재샘플링하는 데 사용했을 때, 벨트 조립 같은 장기 과제에서 가장 좋은 결과를 얻었다.
접촉 단계를 업샘플링하면 해당 구간의 검증 손실이 낮아지고, 정렬에 실패했을 때 더 많은 복구 행동이 나타난다.
약 10분의 자유 동작 데이터로 충분했으며, 30~40분으로 늘려도 성능이 향상되지 않았다.
PACE: 청크 기반 삽입 정책을 위한 시간적 역할 촉각 조건화 (PACE: Temporal-Role Tactile Conditioning for Chunk-Based Insertion Policies)
Zane (presenting for the authors) · Xiaomi Robot Technology
전체 저자
Zhiyuan Chen1, Shixiong Xu1, Shuai Chen1, You Yangwei1
1Xiaomi Robot Technology
비자 지연으로 참석하지 못한 제1저자 Zhiyuan Chen(Xiaomi Robotics)을 대신해 Zane이 발표했다. PACE는 청크 기반 삽입 정책에서 하나의 공유 촉각 스트림에 세 가지 시간적 역할을 부여한다. 평활화된 접촉 상태로 트랜스포머 특징을 조절하는 단계(phase) 경로, 급격한 접촉 변화 시 청크의 첫 행동들에 대한 잔차 보정을 게이팅하는 이벤트 경로, 그리고 학습에만 사용되는 보조 미래 촉각 예측 헤드다. 시연은 Sigma.7 힘 피드백 원격 조작 시스템으로 수집했다.
핵심 내용
PACE는 5개의 실제 삽입 과제에서 평균 90.7%의 성공률을 달성해, 가장 강력한 촉각 연결(concatenation) 기준선의 46%를 크게 앞섰으며, 0.1 mm의 좁은 간극을 포함한 Manipulation-Net에서도 88.7%를 기록했다.
Kallol Saha는 장기 다중 물체 재배치를 위한 AlphaGo 방식의 레시피인 DISCO를 소개한다. 픽 앤 플레이스 정책이 점진적 확장(progressive widening)을 사용하는 연속 행동 MCTS 트리의 간선으로 행동을 제안하고, 성공과 실패를 주기적으로 정책과 가치 함수에 다시 증류하며, 이를 GPU 시뮬레이션에서 병렬로 실행한다. 최종 정책은 테스트 시 탐색 없이 선반 채우기, 쌓기, 테이블 치우기 과제를 수행하며, sim-to-real 전이도 포함한다.
핵심 내용
노드 방문 횟수가 늘어날수록 자식 노드를 추가하는 점진적 확장 덕분에 연속 행동 공간에서도 트리 탐색이 가능해진다.
DISCO는 빔 탐색, MPPI, RL, 그리고 균일 탐색이나 고정 분기 계수를 사용하는 어블레이션보다 우수하다.
증류 라운드마다 정책과 가치 함수가 모두 개선되므로, 단기 데이터로부터 장기 추론을 학습하게 된다.
행동 복제만으로 만든 초기 정책은 실제 장기 과제에서 실패하지만, 증류된 DISCO 정책은 이를 완수한다.
GRAIL: 월드 모델로부터 휴머노이드 로코-매니퓰레이션 생성하기 (GRAIL: Generating Humanoid Loco-Manipulation from World Models)
Tianyi Xie · NVIDIA / UCLA
전체 저자
Tianyi Xie1,2, Haotian Zhang1, Jinhyung Park1, Zi Wang1, Bowen Wen1, Jiefeng Li1, Xueting Li1, Qingwei Ben1, Haoyang Weng1, Yufei Ye1, David Minor1, Tingwu Wang1, Chenfanfu Jiang2, Sanja Fidler1, Jan Kautz1, Linxi Fan1, Yuke Zhu1, Zhengyi Luo1, Umar Iqbal1, Ye Yuan1
1NVIDIA2UCLA
저자들은 휴머노이드 로코-매니퓰레이션 데이터를 수집하는 대신 생성할 것을 제안한다. 구축된 3D 장면의 단일 이미지에서 출발해, 텍스트 프롬프트로 비디오 파운데이션 모델을 구동하여 인간 시연(앉기, 밀기, 나르기, 계단 오르기, 연석 올라서기)을 만들어 낸다. 특권 정보인 장면 기하와 카메라 파라미터를 이용해 사람과 물체의 움직임을 재구성하고, 키가 맞는 인간 캐릭터를 선택하는 방식으로 로봇에 리타기팅한 뒤, 장면과 지형을 인식하는 전신 트래커로 물리적으로 타당하게 만든다. 이 트래커들로부터 증류되어 전적으로 시뮬레이션에서 학습된 시각 정책은 실제 휴머노이드에 제로샷으로 배포된다.
핵심 내용
GRAIL은 35k개 이상의 물리적으로 타당한 동작을 생성했으며, 발표 시점에 공개 데이터셋의 다운로드 수는 약 25만 회에 달했다.
GRAIL 데이터만으로 학습한 집어 들기 정책은 실제 로봇에 제로샷으로 전이되어 처음 보는 물체에서 80%의 성공률을 보였다.
수천 가지 계단 변형을 가상으로 생성하면 모션 캡처로는 현실적으로 달성할 수 없는 지형 커버리지를 얻을 수 있으며, 계단 정책은 처음 보는 실내외 계단으로 일반화되었다.
비디오 모델과 포즈 추정기가 인간에 대해서는 성숙했기 때문에 저자들은 여전히 인간 영상으로부터 리타기팅하지만, 두 기술이 로봇에 맞게 파인튜닝되면 휴머노이드 영상을 직접 생성하게 될 것으로 예상한다.
SuperMimic은 시뮬레이터 전이 데이터로 맞춘, 모든 동작에 공통인 동역학의 미분 가능한 월드 모델 하나를 학습하고, 이를 통해 1차 그래디언트(SHAC 방식)와 크리틱으로 트래킹 정책을 하나의 교대 루프에서 학습함으로써 범용 휴머노이드 모션 트래킹을 확장한다. Liao는 월드 모델과 트래커가 외란에 반응하는 라이브 데모를 보여 주며, 하나의 모델을 여러 동작에 걸쳐 분할 상환(amortize)하면 데이터가 늘어나도 모델 오차가 일정하게 유지된다고 주장한다. 결과로 얻은 범용 트래커는 상상 속에서 학습되었음에도 실제 Unitree G1에 전이된다.
핵심 내용
Liao는 SONIC이 100개 이상의 GPU로 일주일이 걸린 데 비해 GPU 한 개로 약 3시간 만에 범용 트래커를 학습했다고 보고하며, 이는 GPU 시간 기준 약 1,000배 감소다. 다만 데이터셋이 더 작고 GPU가 더 빠르다는 점은 인정한다.
상상 롤아웃은 시뮬레이션보다 10배 이상 빠르며, 모델을 통한 1차 그래디언트는 같은 모델에서 PPO보다 훨씬 적은 스텝을 필요로 한다.
더 오래 학습하자 약 100,000개의 동작 전반에서 트래킹 실패가 0건에 도달했다.
코드는 발표 도중 오픈소스로 공개되었으며, 이미 다른 이들이 이를 재구현해 스피드런, 근육 구동 휴머노이드, 참조 동작 없는 희소 보상 조작으로 확장했다.
RoboNaldo: 모션 가이드 커리큘럼 강화학습을 통한 정확하고 안정적이며 강력한 휴머노이드 축구 슈팅 (RoboNaldo: Accurate, Stable and Powerful Humanoid Soccer Shooting via Motion-Guided Curriculum Reinforcement Learning)
Hongyang Li · Archon Robotics / The University of Hong Kong
1The University of Hong Kong2Archon Robotics3The Chinese University of Hong Kong
RoboNaldo는 3단계 모션 가이드 커리큘럼으로 축구 슈팅을 위한 단일 저수준 휴머노이드 정책을 학습한다. 먼저 하나의 인간 킥 참조 동작을 트래킹하고, 이어 트래킹된 타격 지점 근처에 공을 초기화해 희소한 과제 보상으로 정확한 슈팅을 학습하며, 마지막으로 공 쪽으로 고정되는 적응형 참조 동작과 킥 타이밍을 위한 휴리스틱 플래너로 보행과 슈팅을 통합한다. 탑재된 LiDAR가 반사형 공을 감지하고 가슴 카메라가 골대의 AprilTag 타깃을 읽으며, 시스템은 Unitree G1으로 실내외 경기장에서 테스트되었다.
핵심 내용
트래킹된 타격 지점 근처에 공을 초기화하면 트래킹 정책이 PPO의 좋은 출발점이 되어 희소 보상 탐색 문제가 해결된다.
실제 로봇의 접촉률은 90%를 넘었고, 발표에서는 정지된 공 킥 조건에서 100% 성공률이 보고되었다.
최대 공 속도는 10 m/s를 넘었으며, 발표자는 이를 프로 선수 슈팅의 약 60%로 추정했다.
sim-to-real 격차가 여전히 실패의 주된 원인이며, 특히 실외 경기장에서 킥 이후의 안정성이 문제다.
Gemini로 범용 로봇 만들기 (Building general purpose robots with Gemini)
Kanishka Rao · Google DeepMind
Rao는 로보틱스의 핵심 문제를 범용 추론과 정교한 전신 제어의 결합으로 규정하고, 이를 프런티어 모델과 로봇 모델 양쪽에서 공략한다. Gemini Robotics 2.0(Apollo 휴머노이드의 전신 제어, 정교한 손, 다중 로봇 협업)을 정리하고, 200개 이상의 과제로 학습되어 안전성이 향상된 Gemini Robotics 2.5와 Mercedes-Benz/Apptronik 생산 라인 키팅 파일럿을 발표한다. 또한 MuJoCo 4와 MuJoCo Playground 1.0을 발표하고, 프런티어 Gemini 모델을 에이전트로 활용해 실제 로그로부터 시뮬레이터를 구축하고, 롤아웃을 분석하며, 휴머노이드에게 콘홀(cornhole) 게임까지 가르친 사례를 소개한다.
핵심 내용
200개 이상의 정교한 과제로 학습하자 이전 모델 대비 성공률이 약 30-100% 높아졌고, 이전에 학습한 과제도 개선되었다.
생산 라인 키팅 파일럿은 96%의 자율 성공률에 도달했다.
프런티어 모델은 이제 real-to-sim-to-real 루프와 자동화된 실패 분석을 통해 로봇 모델 개발을 가속하고 있으며, Gemini Robotics 2.5 구축에도 사용되었다.
Rao는 프런티어 모델이 로보틱스의 더 많은 부분을 맡게 될 것이며, 이러한 모델이 빨라짐에 따라 에이전트형 폐루프 로봇 제어가 도래할 것으로 예측한다.
진정한 장기 행동을 위한 액션과 에이전트 (Actions and Agents for True Long-Horizon Behavior.)
Alberto Rodriguez · Boston Dynamics
Rodriguez는 Hyundai의 Savannah 공장에서 부품 시퀀싱을 수행하는 Atlas의 초기 배포 사례를 보고한다. 공급업체 컨테이너에서 부품을 집고, 양손으로 바코드를 스캔하고, 올바른 슬롯에 순서대로 삽입하며, 떨어뜨렸거나 불량인 부품은 폐기한다. 시스템은 텍스트 작업 설명과 공장 작업 지시를 읽는 파인튜닝된 Gemini ER 추론 모델(시스템 2)을 중심으로 한 클라우드 '작업 하네스(job harness)'와, 약 400시간의 원격 조작 데이터로 사후학습되어 NVIDIA Thor에서 구동되는 로봇 탑재 단일 액션 모델(시스템 1)을 사용한다. 그는 스킬 분해보다 단일 액션 모델을, 규모보다 데이터 품질을 옹호한다.
핵심 내용
개입을 포함한 엔드투엔드 완료율은 98.6%였으며, 개입률은 9.5%로 약 20분에 한 번꼴이었다.
사이클 타임은 과제당 약 2분으로, 경제적 가치에 필요한 분당 1개 속도보다 약 50% 느리다. Boston Dynamics는 Atlas의 첫 8시간 생산 교대 근무를 2027년으로 예측한다.
기성 프런티어 VLM 중 파인튜닝 없이 과제 완료 확인과 슬롯 단위로 정밀한 조향에 충분히 신뢰할 만한 것은 없었다.
Rodriguez는 시뮬레이션에서의 대규모 RL을 고품질 데이터로 가는 길로 보며, RGB만 사용하는 정책에서 창발한 정교한 행동을 보여 준다.
피지컬 AI를 위한 레퍼런스 플랫폼 (The Reference Platform for Physical AI)
Sven Parusel · Franka Robotics / Agile Robots
Parusel은 토크 감지 7-DoF 팔인 Franka Research 3와 1 kHz Franka Control Interface를 기반으로, 피지컬 AI 연구를 위한 레퍼런스 하드웨어 및 소프트웨어 플랫폼이 되겠다는 Franka의 목표를 설명한다. 그는 FR3 Duo 양팔 시스템과 홀로노믹 베이스를 갖춘 새로운 모바일 FR3 Duo, 그리고 다양한 원격 조작 인터페이스를 소개한다. 또한 원격 조작, 센서 수집, 라벨링, 학습, 추론을 아우르는 Franka의 최근 오픈소스 데이터 파이프라인과 DualBench 벤치마크 논문을 강조한다.
핵심 내용
한 해 동안 2,000편 이상의 논문이 Franka 로봇을 사용했으며, CoRL 2024에서는 단일 팔 논문의 절반 이상이 Franka를 사용했다.
Parusel은 관절 토크 감지와 고속 인터페이스를 통한 완전한 모델 접근(자코비안, 질량 행렬)을 접촉이 많은 연구와 HRI 연구에서 쓰이는 이유로 꼽는다.
고정된 카메라와 그리퍼를 갖춘 표준화된 양팔 구성은 연구실들이 서로의 연구를 재현하고 공통 임바디먼트에서 데이터를 모을 수 있게 하기 위한 것이다.
Franka는 데이터 수집 및 학습 파이프라인을 오픈소스로 공개했으며, 새로운 입력 장치와 라벨링 도구의 기여를 환영한다.
접촉이 많은 과제에서 VLA가 언제, 왜 실패하는지와 그 해결법 밝히기 (Demystifying When and Why VLAs Fail in Contact-Rich Tasks and How to Fix Them)
Carlota Parés Morlans · Stanford University (녹화에서 발표자가 언급되지 않아 제1저자를 표시)
전체 저자
Carlota Parés Morlans1, Nils Kuhn1, Y. Isabel Liu1, Alberta Longhini1, Jeannette Bohg1
1Stanford University
저자들은 접촉이 많은 과제에서의 VLA 실패를 두 가지로 추적한다. 하나는 플로 매칭 노이즈 스케줄이 접촉 직전의 작은 행동에 가중치를 충분히 주지 않아 생기는 정밀도 실패이고, 다른 하나는 힘 실패다. 첫 번째는 logit-normal 노이즈 스케줄로 바꾸어, 두 번째는 시간 인식·접촉 게이트 방식의 힘 주입으로 해결한다.
핵심 내용
사후학습 시 beta 스케줄을 logit-normal 스케줄로 바꾸는 것은 추가 파라미터나 데이터 없이 바로 적용할 수 있는 해결책이다.
5개 과제에 걸친 2,500회의 실제 롤아웃에서 이 방법은 66%의 성공률을 달성해 최고 기준선보다 25%p 높았다.
PGRD는 최적화 가능한 스프링-질량 시뮬레이터와 잔차 보정을 예측하는 학습된 네트워크를 결합하여, 로프나 단단한 자루와 부드러운 깃털로 이루어진 먼지떨이 같은 변형체를 모델링한다. 이를 MPPI와 함께 사용해 로프 경로 재설정을 수행하며, 목표는 이미지 모델을 통해 언어로부터 생성한다.
핵심 내용
이 하이브리드 모델은 이질적인 물체의 자루는 단단하게 유지하면서 깃털은 변형시켰는데, 순수 스프링-질량 기준선과 학습 기반 기준선은 이를 해내지 못했다.
Ani Majumdar의 소개를 받은 Tedrake는 Walden Robotics(2026년 1월에 시작된 Toyota Research Institute 스핀아웃) 창업이 로보틱스에 대한 자신의 시각을 어떻게 바꾸었는지 설명하며, 기술은 이미 준비되었고 다음 장벽은 범용 로봇을 제품으로 만드는 일이라고 주장한다. 그는 엄격한 가동률과 안전 요건 아래 Toyota 공장에서 캠샤프트를 적재하는 Walden의 첫 배포 사례를 소개하는데, 원격 어시스턴트와 함께하는 HG-DAGGER 방식의 공유 자율성과 매주 무선(OTA) 모델 업데이트를 활용했다. 이어 현장 배포 데이터가 가장 가치 있는 데이터라고 주장하며, 더 강력한 사전학습 모델이 개입 데이터를 더 적게 수집하고도 그로부터 더 크게 개선된 실험을 제시한다. 마지막으로 소수가 다수를 감독하기 위한 런타임 실패 모니터링, Toyota 생산 방식(jidoka, 라인 정지, 5 whys)에서 얻은 교훈, 그리고 Toyota와 함께하는 로봇 대량 생산을 다룬다.
핵심 내용
Walden의 캠샤프트 배포는 인간 원격 지원과 AI를 합쳐 거의 100%의 성공률에 이르기 때문에 생산 라인을 한 번도 멈춘 적이 없다.
최근 대규모 모델 학습 후 평균 개입 간격이 약 340초로 늘었으며, Tedrake는 이 정도면 원격 어시스턴트 세 명이 로봇 50대를 감독할 수 있다고 추산한다.
새로운 작업에 대한 공유 자율성 파인튜닝에서 가장 강력한 베이스 모델은 가장 적은 개입 데이터를 돌려받았지만(가장 약한 모델의 약 2시간에 비해 약 1.36시간) 가장 크게 개선되었다. 즉 강력한 베이스 모델일수록 배포 데이터의 가치가 커진다.
모델이 개선되면 개입의 성격이 달라지므로, 약한 모델에는 자율 비율이, 강한 모델에는 평균 개입 간격이 더 나은 지표다.
개입 데이터만으로 학습하면 근본 원인을 놓친다. Tedrake는 실패 후 Toyota 방식의 사후 분석과 표적 데이터 수집을 옹호한다.
그는 현재의 병목이 AI가 아니라 로봇의 대량 생산이라고 보며, 로봇이 로봇을 만들게 하고 Toyota와 대량 생산을 위해 협력하는 방식으로 이를 추진하고 있다.
가정용 자율 휴머노이드 만들기 (Building an Autonomous Humanoid for the Home)
Jonathan Tompson · Meta Robotics Studio (Reality Labs)
Meta Robotics Studio의 모델링 리드인 Tompson은 유용하면서(자율적인 가사 작업) 즐거움을 주는(안전하고 친근하며 소통하는) 가정용 휴머노이드를 액추에이터부터 프런티어 모델까지 풀스택으로 구축한다는 팀의 목표를 설명한다. 하드웨어는 공개하지 않은 채 모델링 접근법을 소개하는데, Aria 안경으로 수집한 1인칭 시점 인간 데이터, UMI 방식 데이터, 일부 로봇 원격 조작 데이터로 학습하고 DAGGER로 개선하는 범용 정교한 파운데이션 모델이다. 그는 Meta가 보유한 기존 자산(Quest의 SLAM과 손 추적, SAM 3와 SAM 3D 같은 비전 모델, FEM 기반 시뮬레이터, Muse 프런티어 모델, 소비자 하드웨어 경험)이 강점이 된다고 주장한다.
핵심 내용
Meta는 Quest 헤드셋의 SLAM과 손 추적 인프라를 로봇에 그대로 재사용한다.
Tompson은 이제 천, 스펀지, 정밀한 강체 접촉에 대한 FEM 시뮬레이션을 포함한 시뮬레이션이 범용 로보틱스에 필수적이라고 강하게 확신한다.
명시적 비전 모델은 에이전트가 데이터 필터링, QA, 상태 추정을 위해 호출하는 도구로서 중요성이 커지고 있다.
Meta는 로보틱스 데이터를 자사 프런티어 모델에 투입하고, 로봇 작업을 위한 에이전트형 도구 호출을 개선하기 위해 RL 사후학습을 수행하고 있다.
로봇 지능의 확장: 인간의 경험에서 자기 개선 로봇까지 (Scaling Robot Intelligence: From Human Experience to Self-Improving Robots)
Yongjian Shen · AGIBOT
Shen은 배포에 기반한 AGIBOT의 피지컬 AI 생태계를 소개한다. 3년간 20,000대 이상의 로봇을 생산했으며, 태블릿 공장 배포와 광저우 지하철의 100대 이상 로봇 배치가 포함된다. 그는 공개 데이터셋 AgiBot World(100만 개 이상의 궤적, 새 릴리스에는 추론 주석 포함), 원격 조작 데이터와 1인칭 시점 인간 데이터로 학습되어 작업 추론, 미래 상태 예측, 동작 생성을 결합한 AGIBOT의 최신 월드-추론-행동 모델, 96대 로봇에 걸친 플릿 수준 집단 경험 학습, 그리고 배포 경험을 재사용 가능한 메모리로 바꾸는 Genie Master를 다룬다. 마지막으로 커뮤니티가 구축한 조작 벤치마크를 소개하는데, 그 주에 네 개의 새 트랙이 추가되었고 시뮬레이션 자산에 대한 실제 환경 검증이 이루어졌다. 강연 중 여러 데모 영상이 재생되지 않았다.
핵심 내용
집단 경험 학습은 96대의 실제 로봇에서 동시에 실행되었으며, AGIBOT은 이를 이 규모로는 최초의 시연으로 본다.
Tesla의 로보틱스 파운데이션 모델 구축 (Building Foundational Models for Robotics at Tesla)
Patrick Cho · Tesla
Cho는 Tesla가 학습된 월드 모델을 활용해 먼저 Cybercab 로보택시, 이어서 Optimus를 위한 강건한 정책을 구축하는 방법을 설명한다. Tesla는 월드 모델을 안전 개입 이후의 반사실적 상황 평가, 수집된 시나리오에서 새 정책의 폐루프 평가, 그리고 정책 학습에 사용한다. 정책 학습에 쓰려면 모델이 인과적이고, 행동에 조건화되며, 다중 카메라 간 일관성을 갖고, 지연이 낮으며, 물리적으로 정확해야 한다. 그는 생성된 희귀 시나리오(떨어지는 나뭇가지, 코끼리, 수족관을 통과하는 주행)와 관절 수준 행동에 조건화되어 실제 데이터와 비교된 Optimus의 보행 및 조작 롤아웃을 보여준다.
핵심 내용
월드 모델을 평가뿐 아니라 학습에 사용하면 정책이 모든 물리적 부정확성을 악용하기 때문에 요구 수준이 급격히 높아진다.
로보택시 개입이 너무 드물어져 이에 대해 테스트할 수 없게 되었으므로, 처음 보는 꼬리(tail) 시나리오를 생성하는 것이 필요하다.
Optimus의 경우 로봇 자체의 물리를 모델링하려면 대상 임바디먼트의 데이터가 필요하며, Tesla는 이것이 Optimus 생산 확대의 동기라고 말한다.
월드 모델은 자동차나 로봇의 실제 행동에 조건화된 범용 비디오 생성기처럼 작동하도록 사내에서 처음부터 학습된다.
RoboKit: 로봇 학습을 위한 병렬 미분 가능 최적화 가속 (RoboKit: Accelerating Parallel Differentiable Optimization for Robot Learning)
Jianglong Ye · UC San Diego
전체 저자
Jianglong Ye1, Xuanbin Peng1, Conor Mc Gartoll1, Changwei Jing1, Lai Wei1, Jiali Chen1, Xueyan Zou1, Xiaolong Wang1
1UC San Diego
저자들은 해석적 야코비안과 여러 옵티마이저를 갖춘 배치형 커널 수준 최적화 툴킷 RoboKit을 소개한다. 이 툴킷은 IK, 모션 플래닝, 리타기팅, 파지, 시뮬레이션 기반 MPC를 다룬다. 또한 최적화와 학습 기반 솔버를 비교해 신경망 방법이 도움이 되는 지점을 보여준다.
핵심 내용
RoboKit은 기존 프레임워크 대비 IK가 약 10x, 물리 리타기팅이 2x, 렌더링 기반 캘리브레이션이 16x 빠르며, 2,000개의 IK 문제를 약 70 ms에 푼다고 보고한다.
IK나 모션 플래닝처럼 잘 정의된 문제에서는 최적화가 이미 좋은 성능을 내며, 학습 기반 방법은 이에 필적하는 수준에 그친다.
학습은 물리가 중요할 때(시뮬레이션으로 학습한 파지), 입력이 부분적인 포인트 클라우드일 때, 그리고 속도가 결정적일 때(학습 기반 모션 플래닝은 수백 배 빠름) 도움이 된다.
GaP: 변형 자동화 작업을 위한 그래프-정책(Graph-as-Policy) 멀티 에이전트 자기 학습 하네스 (GaP: A Graph-as-Policy Multi-Agent Self-Learning Harness For Variational Automation Tasks)
Shuangyu Xie · UC Berkeley
전체 저자
Kaiyuan Chen1, Shuangyu Xie1, Letian Fu1, Justin Yu1, William Pacini1, Sandeep Bajamahal1, Hudson Kim1, Jaimyn Drake1, Daehwa Kim1, Haoru Xue1, Jonathan Francis2, Christian Juette2, Peter Schaldenbrand2, Muhammet Yunus Seker2, Ruwan Wickramarachchi2, Uksang Yoo1, Guanzhi Wang3, Adithyavairavan Murali3, Balakumar Sundaralingam3, S. Shankar Sastry1, Yuke Zhu3, Linxi Fan3, Spencer Huang3, Ken Goldberg1
1UC Berkeley2Bosch3NVIDIA
GaP는 변형 자동화(variational automation) 작업을 대상으로, 로봇 프로그램을 계산 그래프로 구조화하고 그 하위 그래프를 코딩 에이전트가 작성, 테스트, 수정하도록 한다. 에이전트 하네스는 시뮬레이션에서 스스로 학습하며, 휴대폰 영상으로 real-to-sim 환경을 구축할 수 있다.
핵심 내용
코드를 그래프로 구조화하면 에이전트가 작성한 정책의 해석 가능성이 유지되고, 에이전트가 루프에 없어도 로봇에서 실행할 수 있다.
시뮬레이션에서의 자기 학습은 평행 그리퍼만으로 물체를 살펴보고, 고르고, 뒤집고, 확인하는 것과 같은 복합 전략을 만들어냈다.
시뮬레이션 물리가 현실과 맞지 않을 때 GaP는 실제 영상을 사용해 시뮬레이션과 그래프를 모두 갱신했다(예: 왼쪽 그리퍼로 막대를 고정).
Meta-Ctrl: 구문적 제약과 의미적 제약의 분리를 통한 보장된 계획 생성 (Meta-Ctrl: Guaranteed Plan Generation by Decoupling Syntactic and Semantic Constraints)
Gwen Yidou-Weng, Edward Sun · UCLA
전체 저자
Gwen Yidou-Weng1, Edward Sun1, Tianyi Ma2, Metin Alp Dogan1, Benjie Wang1, Allen Peng1, Guy Van den Broeck1, Yuchen Cui1
1UCLA2Michigan State University
Meta-Ctrl은 LLM이 생성한 로봇 계획이 전제 조건과 목표 도달 가능성을 모두 포함한 전체 계획 규칙을 만족하도록 보장하는 제약 디코딩 방법이다. 한 번의 역방향 패스로 부분 계획이 여전히 목표에 도달할 수 있는 확률을 계산하고, 구문은 별도로 검사하면서 행동 수준 메타 토큰마다 세계 상태를 추적한다.
핵심 내용
스텝별 마스크는 불법 행동을 걸러내지만 정체되거나 끝내 목표에 도달하지 못하는 계획은 막을 수 없으므로, 목표까지의 예견(look-ahead)이 필요하다.
각 행동을 하나의 메타 토큰으로 다루고 구문을 세계 상태와 분리하면 상태 폭발을 피할 수 있다(토큰 수준 접근법에서는 약 3억 5천만 개 상태와 100 TB 이상).
VirtualHome에서 Llama 3B의 성공률은 20%에서 90%로 올랐고, 실제 로봇 계획은 20/20회 유효했으며 가이드 없는 모델은 약 2회에 그쳤다.
ATOM-Bench: 조작 정책의 원자적 스킬과 조합적 일반화를 위한 실제 환경 벤치마크 (ATOM-Bench: A Real-World Benchmark for Atomic Skills and Compositional Generalization in Manipulation Policies)
Zenan Wu · BAAI / Peking University (녹화에서 발표자가 언급되지 않아 제1저자를 표시)
전체 저자
Zenan Wu1,2, Bingqing Wei1,2, Lu Liu1, Zheqi He1, Wang Xi1, liujiakang1, lizehui1,2, Guocai Yao1, Jing-Shu Zheng1, Xi Yang1, Yongtao Wang2
1BAAI2Peking University
ATOM-Bench는 정책을 원자적 운동 스킬과 지시 스킬로만 파인튜닝한 뒤, 보류된 조합 작업에서 이 스킬들을 재조합할 수 있는지를 테스트하는 실제 환경 벤치마크다. 작업 완료, 부분 진행도, 원자적 역량, 진단 점수를 보고한다.
핵심 내용
이 벤치마크는 Franka와 두 번째 로봇 플랫폼에 걸쳐 여섯 가지 운동 원자 유형과 일곱 가지 지시 원자 유형을 정의한다.
다섯 가지 정책 전반에서 단순한 지시 그라운딩은 가장 쉬웠지만, 정밀한 운동 제어, 개수 세기, 조합적 일반화는 여전히 어렵다.
개별 원자를 모두 성공하는 정책도 하나의 작업에서 원자들을 결합해야 할 때는 실패할 수 있다.
수 9:00 AM · Hilton Austin · 좌장: Roberto Martín-Martín
9개 발표
스포트라이트
Kamino: 기구학적 루프를 가진 강체 다물체 물리의 GPU 기반 시뮬레이션 (Kamino: GPU-based Simulation of Rigid Multi-Body Physics with Kinematic Loops)
Vassilios Tsounis · Disney Research
전체 저자
Vassilios Tsounis1, Guirec Maloisel1, Christian Schumacher1, Ruben Grandia1, Agon Serifi1, David Müller1, Chris Amevor2, Tobias Widmer2, Moritz Bächer1
1Disney Research2NVIDIA
Kamino는 NVIDIA의 Newton 프레임워크 내 GPU 기반 물리 솔버로, 기구학적 루프를 가진 강체 다물체 시스템의 대규모 병렬 시뮬레이션을 위한 것이다. Disney의 복잡한 오디오 애니매트로닉스 캐릭터에서 동기를 얻었으며, 강연 중 발표자의 슬라이드와 영상이 맞지 않았다.
핵심 내용
Kamino는 기구학적 루프, 다중 접촉 결합, 큰 질량비를 다루면서도 큰 시간 간격에서 안정적인 제약 최대 좌표(maximal-coordinate) 정식화를 사용한다.
수천 개의 이질적인 월드를 동시에 시뮬레이션하므로, 단일 RL 정책이 다리 수가 서로 다른 개미 변형들을 제어할 수 있다.
Newton은 여섯 개의 기구학적 루프를 가진 공개 데모 이족 로봇을 제공하며, Kamino는 해석적 토이 문제에서 XPBD 및 MJWarp와 비교 검증되었다.
TactileStep: 휴머노이드 보행에서 발-지형 상호작용 조절을 위한 발바닥 촉각 학습 (TactileStep: Sole Tactile Learning for Regulating Foot--Terrain Interaction in Humanoid Locomotion)
Zizhuo Wang · Tsinghua University (녹화에서 발표자가 언급되지 않아 제1저자를 표시)
CMP: 역량 매니폴드 투영을 통한 이동 조작용 강건한 전신 추적 (CMP: Robust Whole-Body Tracking for Loco-Manipulation via Competence Manifold Projection)
Ziyang Cheng · Tsinghua University (녹화에서 발표자가 언급되지 않아 제1저자를 표시)
전체 저자
Ziyang Cheng1, Haoyu Wei1, Hang Yin1, Xiuwei Xu1, Bingyao Yu1, Jie Zhou1, Jiwen Lu1
1Tsinghua University
Competence Manifold Projection은 실행 불가능하거나 분포 밖(OOD) 명령을 정책이 실제로 숙달한 행동으로 투영해 전신 트래커를 강건하게 만든다. MDP를 단일 스텝 안전성 테스트로 축소하고, GAE 방식의 역량 추정을 사용하며, 동형 잠재 공간에서 단 한 번의 노름 검사로 보정한다.
핵심 내용
로봇은 치명적으로 실패하는 대신 최선을 다한다. 예를 들어 상자가 없으면 올라서기를 앞으로 내딛기로 바꾸고, 의자 없이 앉으라는 명령을 받으면 쪼그려 앉는다.
OOD 명령 하에서 실제 환경 생존율은 0%에서 87%로 올랐고, 추가되는 지연이나 추적 오차는 무시할 만한 수준이었다.
안전성이 분포 내 민첩성을 희생시키지 않으며, 짐벌처럼 엔드 이펙터를 유지하거나 공중에서 물체를 잡는 동작도 여전히 가능하다.
1UC Berkeley2Peking University3NVIDIA4Tsinghua University5The University of Hong Kong6Princeton University
저자들은 복잡한 실내 환경을 통과하는 휴머노이드 내비게이션을 위한 3-시스템 전신 VLA를 제시한다. 내비게이션 파운데이션 모델, 실시간 청킹을 갖춘 디퓨전 트랜스포머 행동 전문가, RL 하위 수준 트래커를 언어가 포함된 64,000개 이상의 시뮬레이션 궤적으로 학습한다.
핵심 내용
평면 2D 행동 공간은 팔, 몸통, 걸음새의 협응이 필요한 3D 장애물 사이 내비게이션에 한계가 있다.
학습 데이터는 전적으로 시뮬레이션에서 나오며, 상체 회피에는 포텐셜 필드를, 하체에는 발걸음 리타기팅을 사용한다.
이 모델은 2D 및 3D 내비게이션 벤치마크에서 최고 수준의 결과를 보고하며, 원격 추론으로 실제 Unitree G1에서 실행된다.
1Tsinghua University2Xi'an Jiaotong University3Beijing University of Chemical Technology4Beijing Information Science and Technology University5Beijing Institute of Technology
MosaicIMU는 이질적인 플랫폼 전반에서 신경망 관성 오도메트리를 수행하는 캐리어 조건부 전문가 혼합(mixture-of-experts) 모델이다. 예측된 속도를 이력 인식 EKF와 융합하며, 두 가지 적응 모드를 제공한다. 오프라인 적응을 위한 경량 잔차 브랜치와 온라인 적응을 위한 라우터 기반 샘플 선택이다.
핵심 내용
캐리어별 고정 헤드는 캐리어 정체성을 경직되게 다루는 반면, 샘플마다 전문가 특징을 조합하면 이전이 더 잘 된다.
사전학습된 MosaicIMU는 캐리어 전반에서 평균 ATE와 RTE를 각각 40%와 34% 줄였다.
Jetson Orin에서 실행되는 캠퍼스 차량의 온라인 적응에서 궤적 오차는 42.60 m에서 7.60 m로 떨어졌다.
저자들은 Vision-and-Language 내비게이션에서 '마지막 3미터 그라운딩 격차'를 지적한다. 에이전트가 반경 안에 들어가면 성공으로 간주되지만, 실제로는 목표를 향하거나 보지 못하는 경우다. 이들은 인스턴스 수준 지표, 새로운 데이터셋, 그리고 플러그 앤 플레이 보정 모듈인 REALM을 제안한다.
핵심 내용
진정한 성공이라면 목표 물체 가까이에 멈추고, 그것을 향하며, 볼 수 있어야 한다.
REALM은 1인칭 RGB와 지시문만 사용하고 가시성 인식 정지를 적용하며, OWLv2로 목표를 그라운딩하므로 백본 변경이 필요 없다.
UniNaVid 뒤에 붙여 실제 로봇에서 시연되었고, Unitree G1에서 이동 후 파지 작업으로도 시연되었다.
마스킹된 오차 제한 뉴로-심볼릭 디퓨전을 통한 운영 제약 하의 UAV-UGV 팀 협력 계획 (Collaborative Planning for UAV-UGV Teams under Operational Constraints via Masked Error-bounded Neuro-Symbolic Diffusion)
Zihao Deng · UMass Amherst (녹화에서 발표자가 언급되지 않아 제1저자를 표시)
전체 저자
Zihao Deng1, Qianhuang Li1, Maggie Wigness2, John G. Rogers III2, Donghyun Kim1, Hao Zhang1
1UMass Amherst2DEVCOM Army Research Laboratory
저자들은 UGV가 이동식 충전소 역할을 하는 UAV-UGV 팀의 공동 행동을 마스킹된 뉴로-심볼릭 디퓨전 모델로 계획한다. 논리 기반 허용성(admissibility)이 샘플링 중에 에너지, 통행 가능성, 충전 제약을 강제한다.
핵심 내용
이질적 그래프 맥락에 대한 1차 논리 규칙 덕분에 엄격한 운영 제약을 디퓨전 샘플링 내부에서 강제할 수 있다.
오차 제한 추론 스케줄링은 예측 엔트로피를 최소화하는 방식으로 다음에 마스크를 해제할 위치를 골라 계획의 최적성을 높인다.
이 접근법은 ROS 도시 시뮬레이션과 Crazyflie UAV 및 LIMO UGV를 사용한 혼합 현실 환경에서 검증되었다.
수 3:00 PM · Bass Hall · 좌장: Yuke Zhu & Peter Stone
1개 발표
기조연설
Atlas: 생성과 재구성을 위한 통합 월드 모델 (Atlas: A Unified World Model for Generation and Reconstruction)
Fei-Fei Li · Stanford University / World Labs
옛 박사과정 제자 Yuke Zhu의 소개 후, Fei-Fei Li는 로보틱스의 핵심 요구(세계 표현, 행동 결과 예측, 데이터 시뮬레이션)가 월드 모델링 문제로 귀결된다고 주장한다. 그녀는 World Labs의 Atlas를 소개하는데, 이는 처음부터 학습된 멀티모달 자기회귀 디퓨전 트랜스포머로, 텍스트, 이미지, 비디오, 깊이 또는 그레이박스 입력을 받아 카메라 조건부 프레임을 출력한다. Atlas는 조밀한 재구성, 몇 장의 시점으로부터의 희소 재구성, 순수 생성까지 하나의 모델로 아우르며, 지상에서 찍은 사진 2장, 8장, 33장으로 Stanford의 Main Quad를 재구성하는 예로 이를 보여준다. 그녀는 강력한 제3자 카메라 제어 생성 결과, 깊이 및 가우시안 스플랫 재구성 결과, 15 fps의 실시간 증류 버전, 그리고 초기 로봇 sim-to-real 활용 사례를 보여준다. 홍보 영상의 첫 공개가 AV 문제로 실패해 강연 막바지에 긴 공백이 있었다.
핵심 내용
Li는 Atlas의 핵심 아이디어를 'viewpoint is all you need'로 설명한다. 다음 토큰 예측과 유사하게, 강한 카메라 조건화를 통해 다음 시점을 예측하는 것이다.
하나의 모델이 조밀한 재구성부터 희소 재구성, 텍스트만으로의 생성까지 전체 범위를 다룬다.
약 50만 건의 인간 판단으로 구성된 제3자 벤치마크에서 Atlas는 카메라 제어 생성 부문 1위를 뚜렷한 차이로 차지했다.
Atlas는 일곱 개 데이터셋에 걸친 깊이 예측에서 특화 모델들을 능가했고, 가우시안 스플랫 재구성 오차에서도 경쟁력 있는 수준이었다.
증류된 실시간 버전은 15 fps로 실행되며, World Labs는 Atlas 월드를 내비게이션 및 조작 로봇 학습에 활용해 실제 환경에 제로샷 배포하는 것을 시험하고 있다.
수 3:00 PM · Bass Hall · 좌장: Yuke Zhu & Peter Stone
1개 발표
대담
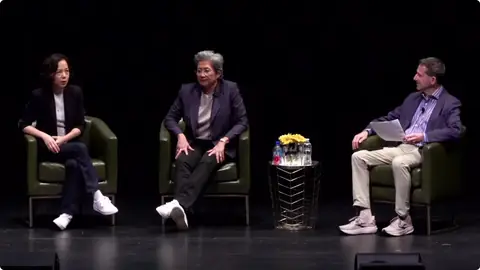
대담: Fei-Fei Li & Lisa Su (Fireside Chat: Fei-Fei Li & Lisa Su)
Fei-Fei Li (Stanford University / World Labs), Lisa Su (AMD), Peter Stone (UT Austin / Sony AI; moderator)
Peter Stone이 Lisa Su(AMD 회장 겸 CEO)와 Fei-Fei Li의 대화를 진행하며, AMD가 진행 중인 World Labs 인수와 Li가 곧 맡게 될 AMD 최고 과학자 역할을 중심으로 이야기가 펼쳐진다. Su는 피지컬 AI와 로보틱스를 수천억 달러 규모의 기회로 보고, 하드웨어-소프트웨어 공동 설계와 클라우드부터 엣지까지 모든 규모의 컴퓨팅이 필요하다고 설명한다. Li는 AI가 곧 컴퓨팅이라고 주장하며 공공 부문에 자원을 제공하지 못하는 것을 지금 이 시점의 가장 큰 실책 중 하나라고 말하고, Su는 AMD가 학술 연구에 컴퓨팅 자원을 할당하겠다고 약속한다. 청중 질문에 답하며 AMD가 로보틱스 팀을 둘지, 박사 학위가 여전히 가치 있는지, 뇌의 20와트에 비견되는 에너지 효율적인 AI, 학생들을 위한 조언 등을 논의한다.
핵심 내용
Su는 어느 한 모델이 모든 응용에서 승리하지는 않을 것으로 본다. 프런티어 LLM은 더 저렴하고 전력 효율적이며 지연이 낮은 특화 모델들로 보완될 것이다.
Li는 로보틱스가 학습과 엣지 양쪽에서 컴퓨팅을 다음 단계로 끌어올릴 것이라고 믿는다.
Li는 공공 부문 컴퓨팅(NAIRR 사업을 예로 들며)이 블루스카이 연구, 인력 양성, AI의 독립적 평가에 필수적이라고 촉구한다.
Su는 AMD가 이미 로보틱스 및 피지컬 AI 연구 조직을 갖추고 있으며, Li 아래에서 투자를 크게 늘릴 계획이라고 말한다.
두 사람 모두 호기심이 원동력인 사람에게는 박사 학위가 가치 있다고 말하며, Li는 뇌의 효율성이 수십억 년의 진화를 반영한 것으로, 이를 학습 비용과 혼동해서는 안 된다고 지적한다.
마지막 조언은 호기심, 정직성, 두려움 없음 같은 시대를 초월한 가치를 붙잡으라는 것(Li)과 가장 어려운 문제를 향해 달려가라는 것(Su)이었다.
토론: "행동 복제 사전학습과 도메인 내 파인튜닝이라는 현재의 레시피가 상업적으로 실현 가능한 범용 로봇으로 이어질 것이다" (Debate: "The current recipe of behavior cloning pre-training and in-domain fine-tuning will lead to commercially viable generalist robots")
Vincent Vanhoucke (Waymo), Chelsea Finn (Stanford University / Physical Intelligence), Pulkit Agrawal (MIT / Eka Robotics), Marc Toussaint (Technical University Berlin), Leslie Kaelbling (MIT), Edward Johns (Imperial College London / Machenta), Yonatan Bisk (Carnegie Mellon University)
Vincent Vanhoucke가 행동 복제 사전학습과 도메인 내 파인튜닝이라는 현재의 레시피가 상업적으로 실현 가능한 범용 로봇으로 이어질 것이라는 논제에 대한 공식 토론을 진행한다. 그는 '범용'을 잘 정의된 도메인 내에서 최종 사용자가 제로샷으로 작업을 바꿔 지정할 수 있는 것으로, '상업적으로 실현 가능'을 고객 매출로 수익을 내는 것으로 정의한다. Chelsea Finn, Pulkit Agrawal, Marc Toussaint는 대규모 도메인 내 데이터, 신뢰성 최적화, 픽 앤 플레이스처럼 좁지만 수익성 높은 도메인을 근거로 찬성 측 주장을 편다. Leslie Kaelbling, Edward Johns, Yonatan Bisk는 인간 시연으로 상태 공간을 덮는 데 드는 비용, 이질적인 아키텍처, 모방을 넘어선 추론의 필요성을 들어 반대한다. 토론 전후 청중 투표에서 장내는 반대 쪽으로 기울었고 의견 변화는 거의 없었다.
핵심 내용
Finn은 신뢰성이 상업적 가치의 핵심이며, 이는 대규모 도메인 내 데이터와 성공에 최적화된 사후학습에서 나온다고 주장한다. LLM이 유용해진 방식도 이와 같다는 것이다.
Kaelbling은 물리적 작업은 언어와 달리 학습 가능하도록 설계된 것이 아니기 때문에 BC가 '폭발적 일반화'를 보여주지 못했으며, 학습된 모델이 정책보다 더 분리 가능하다고 주장한다.
Johns는 작업별 데이터 수집에 사람을 고용하는 것은 대부분의 작업에서 비경제적이며(빨래 개기는 예외), 시뮬레이션이 유력한 경로라고 지적한다.
Agrawal은 시스템 2 계획은 LLM이 대체로 해결했고, 병목은 접촉이 많은 시스템 1 제어이며, 올바른 지표는 정확도가 아니라 처리량(속도 x 신뢰성)이라고 주장한다.
Toussaint는 최선의 과학은 아닐지라도 좁은 상업 도메인은 데이터로 커버할 수 있다고 주장하고, Bisk는 모방만으로는 안전이 중요한 배포에 필요한, 보지 못한 상황에 대한 추론을 만들어낼 수 없다고 주장한다.
토론의 상당 부분은 시뮬레이션과 RL 파인튜닝이 '현재의 레시피'에 포함되는지 같은 정의 문제를 두고 전개되었다.
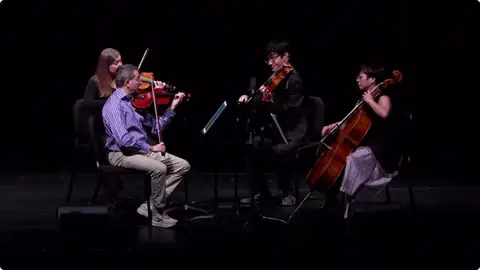
음악 간주: 로봇이 지휘하는 현악 4중주 (Musical Interlude: Robot-Conducted String Quartet)
Peter Stone · UT Austin
대회장 Peter Stone이 첼리스트 Shu Scott, 비올리스트 Alan Chen, 바이올리니스트 Mary Brown과 함께 현악 4중주에서 바이올린을 연주하며, 모두 UT Austin과 인연이 있다. 이들은 Dvořák의 'American' 현악 4중주 마지막 악장과 Turtle Island String Quartet의 'Spider Dreams'를 연주한다. 로봇이 지휘할 예정이었지만 기술적 고장으로 나오지 못했다. 이어 Yuke Zhu가 Stone에게 감사를 전하고 시상식을 예고한다.
핵심 내용
예정되었던 로봇 지휘자는 기술적 고장으로 등장하지 못했으며, Stone은 이를 그날의 또 다른 AV 사고라고 농담했다.
이 간주는 최고 수준의 연구자들이 다른 분야에서도 뛰어날 수 있음을 보여주는 자리로 소개되었다.
폐회사, 시상 및 작별 인사 (Closing Remarks, Awards & Farewell)
Yuke Zhu (UT Austin / NVIDIA), Georgia Chalvatzaki (TU Darmstadt), Katerina Fragkiadaki (Carnegie Mellon University), Vincent Vanhoucke (Waymo), Ken Goldberg (UC Berkeley), Peter Stone (UT Austin / Sony AI)
대회장 Yuke Zhu는 조직위원회, 리뷰어, Robot Learning Foundation, 약 75명의 자원봉사자, 스폰서에게 감사를 전하며, 올해 학회 규모가 대략 세 배로 커졌다고 언급한다. 수상위원장 Katerina Fragkiadaki는 위원회가 21편의 구두 발표 논문을 모두 읽고 여섯 편의 최종 후보(SuperMimic, Play2Perfect, GRAIL, RoboTTT, What Are We Actually Benchmarking in Robot Manipulation?, 그리고 증류된 트리 탐색 재배치 논문)를 선정한 뒤 두 편의 수상작을 골랐다고 설명한다. 최우수 학생 논문상은 RoboTTT에, 최우수 학회 논문상은 SuperMimic에 돌아갔다. Vincent Vanhoucke는 연중 상시 운영되는 Transactions on Robot Learning과 내년부터 시작되는 Test of Time 상을 발표하고, Ken Goldberg는 로보틱스의 '수익 위기'에 대해 성찰하며 파리에서 열릴 CoRL 2027을 발표한다.
핵심 내용
최우수 학생 논문상: RoboTTT: Context Scaling for Robot Policies.
최우수 학회 논문상: SuperMimic: Scaling Humanoid Whole-Body Control with One Differentiable World Model.
수상작은 중요성과 장기적 영향, 독창성, 기술적 타당성, 명료성, 재현성과 개방성을 기준으로 심사되었다.
새로운 Transactions on Robot Learning은 연중 상시로 투고를 받으며 우수 논문은 CoRL에서 발표되고, 2017년 이후 논문을 대상으로 하는 Test of Time 상이 내년부터 시작된다.
Goldberg는 이 분야가 이제 수익을 내려면 신뢰성, 처리량, 해석 가능성을 실현해야 한다고 주장하며, 파리에서 열릴 CoRL 2027을 발표한다.